Catégorie : Informatique, Cloud & Cybersécurité

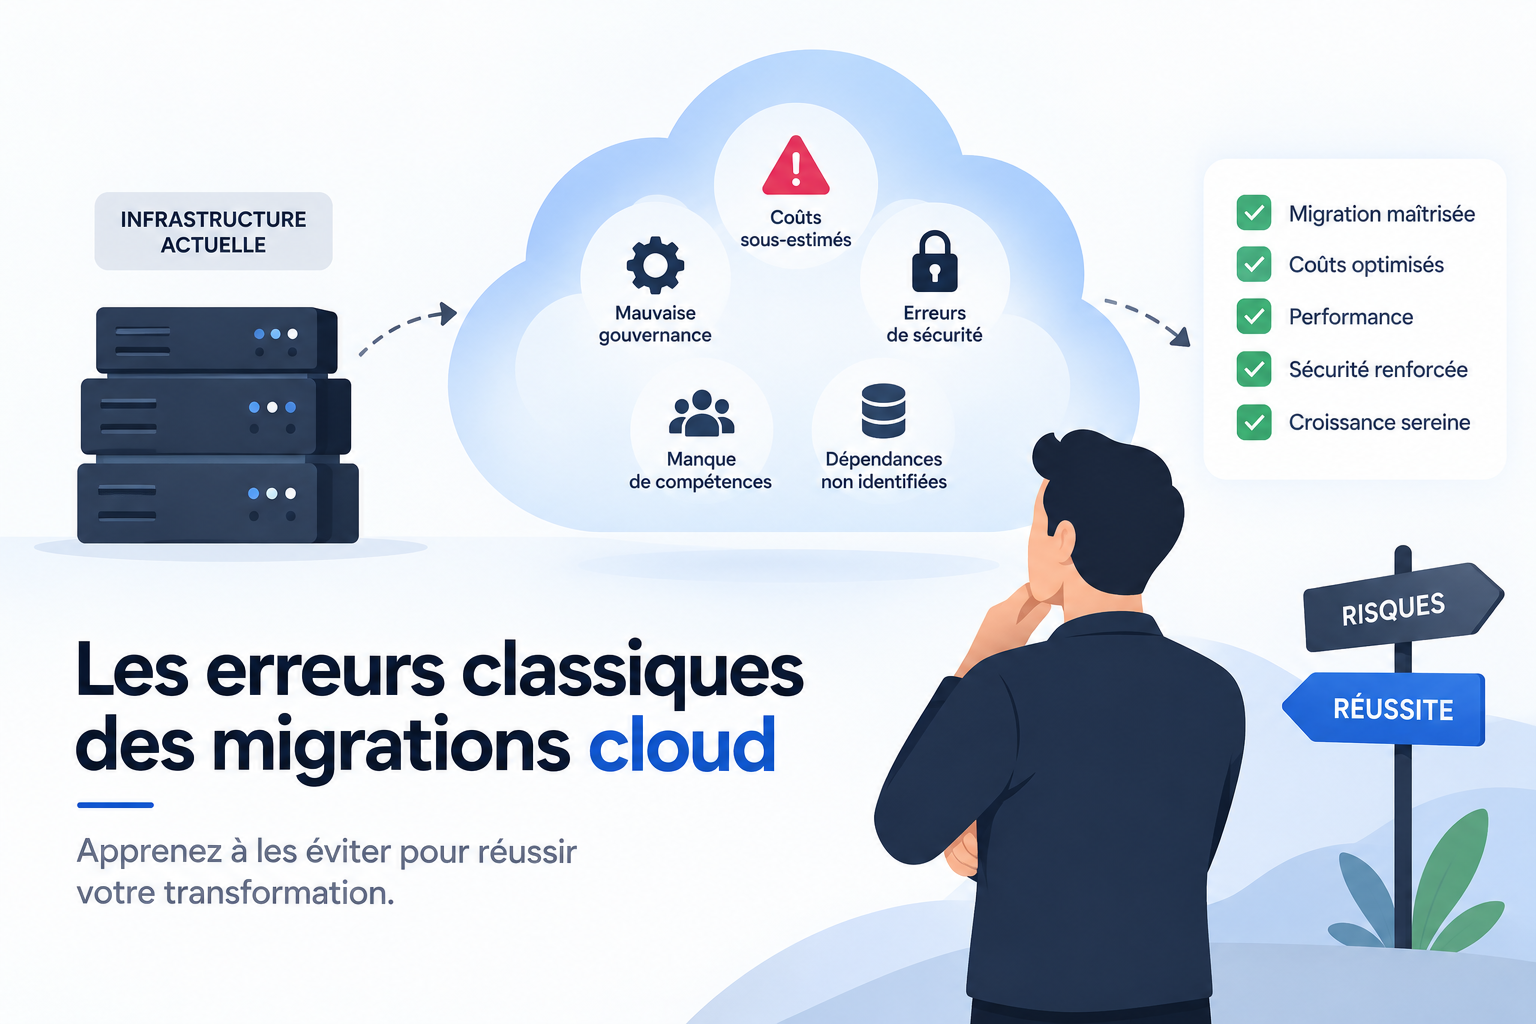
  • Les erreurs classiques des migrations cloud : les pièges à éviter pour réussir sa transformation.

    Les erreurs classiques des migrations cloud : les pièges à éviter pour réussir sa transformation.


    Migrer vers le cloud paraît parfois simple sur le papier.

    On prend une application.

    On la déplace.

    On éteint les anciens serveurs.

    Et c’est terminé.

    Dans la réalité, une migration cloud peut rapidement devenir l’un des projets les plus complexes d’une entreprise.

    Des coûts qui explosent.

    Des applications plus lentes qu’avant.

    Des équipes qui ne maîtrisent pas la nouvelle infrastructure.

    Des droits d’accès mal configurés.

    Des services qui tombent en panne au moment du basculement.

    Et parfois, après plusieurs mois et beaucoup d’argent dépensé, une question particulièrement inconfortable apparaît :

    “Qu’est-ce que cette migration nous a réellement apporté ?”

    Le problème n’est pas nécessairement le cloud.

    Le problème est souvent la manière dont la migration a été préparée, exécutée et exploitée.

    Les grands frameworks d’adoption cloud recommandent aujourd’hui de traiter une migration non comme un simple déplacement technique, mais comme un programme impliquant objectifs business, inventaire des workloads, gouvernance, sécurité, compétences, responsabilités et suivi financier. Microsoft insiste notamment sur la nécessité de définir le modèle opérationnel, les responsabilités, les compétences, les coûts estimés et les caractéristiques de chaque workload avant la migration.

    Autrement dit :

    La majorité des erreurs graves d’une migration cloud commencent souvent avant même que la première application soit déplacée.

    Voici les plus importantes.


    Erreur n°1 : migrer vers le cloud sans savoir pourquoi

    C’est probablement l’erreur la plus fondamentale.

    Une direction décide :

    “Il faut aller dans le cloud.”

    Pourquoi ?

    Parce que :

    • les concurrents y sont ;
    • le fournisseur actuel vieillit ;
    • le cloud semble moderne ;
    • quelqu’un a présenté une stratégie “cloud first”.

    Mais aucun objectif business précis n’est défini.

    Résultat :

    l’entreprise réalise une migration techniquement correcte…

    sans savoir si elle est réussie.

    Avant de migrer, il faut répondre à une question simple :

    Quel problème cherchons-nous réellement à résoudre ?

    Cela peut être :

    • réduire le délai de mise en production ;
    • améliorer la résilience ;
    • diminuer certains investissements matériels ;
    • moderniser une application ;
    • faciliter l’expansion internationale ;
    • absorber des pics de trafic ;
    • accélérer l’accès à l’IA ou à la data ;
    • sortir d’un datacenter arrivant en fin de vie.

    Ces objectifs sont très différents.

    Ils impliquent donc des architectures et des stratégies différentes.

    Microsoft recommande d’ailleurs de transformer la stratégie cloud en plan d’adoption explicitement lié aux objectifs de l’organisation et aux workloads concernés.

    Comment éviter cette erreur ?

    Définissez avant la migration :

    • 3 à 5 objectifs maximum ;
    • des indicateurs mesurables ;
    • une situation de référence.

    Par exemple :

    Temps de création d’un environnement aujourd’hui : 12 jours.
    Objectif après migration : moins de 2 heures.

    Voilà un indicateur.


    Erreur n°2 : croire que migrer signifie simplement déplacer les serveurs

    C’est le fameux :

    lift and shift.

    L’entreprise possède :

    20 machines virtuelles dans son datacenter.

    Elle recrée :

    20 machines virtuelles dans le cloud.

    Elle déplace tout.

    Puis annonce :

    “Nous avons migré vers le cloud.”

    Techniquement, oui.

    Mais elle conserve exactement :

    • les mêmes architectures ;
    • les mêmes surdimensionnements ;
    • les mêmes dépendances ;
    • parfois les mêmes problèmes.

    Avec un nouveau modèle de facturation.

    Le lift and shift peut être parfaitement pertinent.

    Par exemple :

    • lorsqu’il faut sortir rapidement d’un datacenter ;
    • lorsqu’une application ne peut pas être facilement modifiée ;
    • comme première étape temporaire.

    Le problème apparaît lorsqu’il devient la stratégie universelle.


    Le piège économique du lift and shift

    Une infrastructure on-premise a souvent été achetée plusieurs années auparavant.

    Le matériel est amorti.

    L’équipe sait le gérer.

    Si vous recréez exactement la même capacité en cloud public et la laissez tourner 24 h/24 toute l’année, le coût peut devenir très différent de ce qui avait été imaginé.

    Le cloud crée surtout de la valeur lorsque vous exploitez intelligemment :

    • élasticité ;
    • services managés ;
    • automatisation ;
    • extinction des ressources inutiles ;
    • dimensionnement dynamique.

    Pas simplement en déplaçant une architecture figée.


    Erreur n°3 : ne pas connaître réellement son système d’information

    Question :

    Combien d’applications votre entreprise possède-t-elle ?

    Réponse :

    “Environ 80.”

    Puis l’inventaire commence.

    Résultat :

    Parmi elles :

    • applications anciennes ;
    • scripts ;
    • bases ;
    • interfaces ;
    • jobs ;
    • flux inconnus ;
    • serveurs que personne n’ose arrêter.

    C’est extrêmement fréquent dans les organisations historiques.

    Une application peut sembler indépendante.

    Puis vous découvrez qu’elle échange chaque nuit avec :

    • une base interne ;
    • un serveur FTP ;
    • une API ;
    • un ERP.

    Vous la migrez.

    Et trois systèmes tombent.


    Pourquoi l’inventaire est indispensable

    Avant de migrer, il faut identifier :

    • applications ;
    • serveurs ;
    • bases ;
    • utilisateurs ;
    • propriétaires ;
    • dépendances ;
    • flux réseau ;
    • sensibilité des données ;
    • criticité métier.

    Les frameworks cloud actuels recommandent précisément de maintenir un inventaire complet des workloads et d’identifier leurs propriétaires, leur criticité et leurs dépendances.

    Sans cela, le projet de migration repose en partie sur des suppositions.


    Erreur n°4 : migrer ce qui devrait être supprimé

    C’est peut-être l’erreur la plus absurde.

    L’entreprise possède une application.

    Elle coûte cher.

    Elle est vieille.

    Personne ne sait exactement qui l’utilise.

    Décision :

    “Il faut la migrer.”

    Pourquoi ?

    “Parce qu’elle est dans le datacenter.”

    Mais pendant l’analyse, on découvre que :

    seize personnes l’utilisent.

    Deux fois par an.

    Et qu’un autre logiciel remplit déjà la même fonction.

    La meilleure migration est alors :

    ne pas migrer.


    La migration est une occasion de faire le ménage

    Pour chaque application, posez plusieurs questions :

    Est-elle encore utilisée ?

    Est-elle réellement utile ?

    Existe-t-il une alternative SaaS ?

    Peut-elle être consolidée avec une autre application ?

    Peut-elle être arrêtée ?

    Migrer quelque chose qui ne crée plus de valeur signifie simplement déplacer de la dette technique.


    Erreur n°5 : sous-estimer les dépendances

    Imaginez :

    l’application A dépend de B.

    B dépend de C.

    C utilise une base qui reste on-premise.

    Vous migrez A.

    Tout fonctionne.

    Mais chaque requête doit désormais traverser une connexion entre :

    cloud ↔ datacenter.

    Résultat :

    latence.

    Instabilité.

    Coût réseau.

    Les dépendances sont l’une des principales raisons pour lesquelles les migrations doivent souvent être organisées par groupes cohérents de workloads plutôt que application par application au hasard.


    Construire des vagues de migration

    Une bonne migration fonctionne généralement par :

    waves.

    Vague 1 :

    applications simples.

    Vague 2 :

    ensemble métier X.

    Vague 3 :

    systèmes critiques.

    Microsoft recommande de planifier ces vagues avec des points de contrôle, des critères de succès, des fenêtres de bascule et des procédures de rollback clairement définies.

    L’objectif :

    réduire la taille du risque à chaque étape.


    Erreur n°6 : croire que le cloud sera automatiquement moins cher

    L’une des promesses historiques du cloud est :

    payez uniquement ce que vous utilisez.

    Mais beaucoup d’entreprises finissent par transformer cela en :

    payez énormément parce que vous utilisez énormément.

    Dans un datacenter traditionnel, créer une nouvelle machine implique souvent une procédure.

    Dans le cloud :

    quelques clics.

    C’est formidable pour la productivité.

    Mais extrêmement dangereux pour les coûts.


    Le problème : personne n’éteint rien

    Développeur A crée :

    une VM de test.

    Projet terminé.

    VM oubliée.

    Développeur B crée :

    une base temporaire.

    Six mois plus tard :

    toujours active.

    Une équipe dimensionne :

    16 CPU.

    Elle en utilise :

    Multipliez cela par plusieurs centaines de ressources.

    La facture grossit progressivement.


    Le coût cloud doit devenir une métrique opérationnelle

    Le FinOps est justement apparu pour traiter cette problématique.

    Le State of FinOps 2026 montre que la discipline dépasse désormais la simple chasse au gaspillage : les équipes s’intéressent davantage à la gouvernance, aux prévisions et à la valeur générée par la dépense technologique.

    Cela signifie que chaque équipe doit progressivement pouvoir répondre :

    Combien coûte mon produit ?

    Combien coûte cette fonctionnalité ?

    Combien coûte ce client ?

    Combien coûte cet environnement ?


    Erreur n°7 : ne pas mettre en place de gouvernance dès le départ

    Au début :

    10 ressources.

    Puis :

    Puis :

    1 000.

    Avec :

    • noms incohérents ;
    • régions différentes ;
    • permissions variables ;
    • ressources sans propriétaire ;
    • environnements inconnus.

    Bienvenue dans le :

    cloud sprawl.


    Qu’est-ce que la gouvernance cloud ?

    La gouvernance définit :

    • qui peut créer quoi ;
    • où ;
    • avec quelles règles ;
    • avec quels budgets ;
    • sous quelle responsabilité.

    Microsoft décrit la gouvernance cloud comme un ensemble de guardrails couvrant notamment sécurité, conformité, coûts, données et provisioning.


    Exemples de règles simples

    Régions autorisées

    Exemple :

    Europe uniquement pour certains workloads.

    Naming convention

    prod-fr-app-client-api

    plutôt que :

    server-test-final-v2.

    Tags obligatoires

    • owner ;
    • projet ;
    • environnement ;
    • centre de coût.

    Types de ressources autorisés

    Certaines machines très coûteuses peuvent nécessiter validation.

    Budgets

    Chaque équipe connaît son budget.


    La bonne gouvernance ne doit pas tuer l’agilité

    Attention au piège inverse.

    Si chaque ressource cloud nécessite :

    14 validations,

    3 réunions,

    2 formulaires,

    vous recréez exactement la bureaucratie que le cloud devait réduire.

    Le bon modèle est :

    autonomie à l’intérieur de garde-fous.


    Erreur n°8 : traiter la sécurité après la migration

    Mauvaise méthode :

    1. migrer ;
    2. faire fonctionner ;
    3. “on sécurisera ensuite”.

    Le problème ?

    Le “ensuite” n’arrive parfois jamais.

    La sécurité doit être conçue dès le début.

    Les recommandations actuelles du Cloud Adoption Framework insistent sur l’intégration de la sécurité à chaque étape du cycle d’adoption, notamment identité, chiffrement, contrôle d’accès, préparation aux incidents et Zero Trust.


    Les erreurs classiques de sécurité

    Permissions trop larges

    “Mettez tout le monde admin pour l’instant.”

    Cette phrase peut créer des années de dette de sécurité.

    Comptes partagés

    Impossible de savoir qui a fait quoi.

    Secrets dans le code

    Clés API.

    Mots de passe.

    Tokens.

    Stockage accessible publiquement

    Configuration accidentelle.

    Logs insuffisants

    Incident détecté trop tard.

    Backups non testés

    Ils existent.

    Mais personne ne sait s’ils fonctionnent.


    Erreur n°9 : confondre sécurité du cloud et sécurité dans le cloud

    Les grands fournisseurs investissent énormément dans :

    • datacenters ;
    • réseau ;
    • sécurité physique ;
    • infrastructure.

    Mais cela ne signifie pas qu’ils sécurisent automatiquement :

    vos applications.

    C’est le principe de responsabilité partagée.

    Vous restez responsable, selon le service utilisé, de nombreux éléments comme :

    • comptes utilisateurs ;
    • permissions ;
    • configurations ;
    • données ;
    • applications ;
    • secrets.

    Une fuite de données liée à un stockage mal configuré peut donc parfaitement se produire sur une infrastructure cloud techniquement très sécurisée.


    Erreur n°10 : oublier les équipes

    Voici un scénario fréquent.

    L’entreprise investit :

    2 millions d’euros

    dans une migration.

    Nouvelle architecture.

    Nouveaux outils.

    Nouveaux services.

    Mais les personnes qui doivent exploiter le système ont :

    deux jours de formation.

    Résultat :

    • peur ;
    • erreurs ;
    • dépendance aux consultants ;
    • résistance.

    Le cloud est autant une transformation organisationnelle que technique.

    Microsoft recommande explicitement de définir un plan de compétences et de formation dans le plan d’adoption cloud.


    Compétences à anticiper

    Selon le projet :

    • architecture cloud ;
    • réseau ;
    • sécurité ;
    • DevOps ;
    • Infrastructure as Code ;
    • observabilité ;
    • FinOps ;
    • data.

    Le manque de compétences doit être traité avant que les équipes soient responsables de la production.


    Erreur n°11 : ne pas clarifier les responsabilités

    Incident à 3 h du matin.

    L’application est indisponible.

    Question :

    Qui intervient ?

    Réponse :

    “Je pensais que c’était l’équipe cloud.”

    L’équipe cloud répond :

    “Nous pensions que c’était l’équipe applicative.”

    Pendant ce temps :

    personne ne résout le problème.


    Définir un modèle opérationnel

    Il faut déterminer clairement :

    Qui gère la plateforme ?

    Qui gère les applications ?

    Qui gère les coûts ?

    Qui gère la sécurité ?

    Qui répond aux incidents ?

    Qui valide les architectures ?

    Microsoft recommande précisément de choisir un modèle opérationnel — centralisé, partagé ou décentralisé — et de documenter explicitement les responsabilités.


    Erreur n°12 : sous-estimer le réseau

    Le cloud attire naturellement l’attention sur :

    • compute ;
    • bases ;
    • stockage.

    Mais le réseau est souvent ce qui crée les mauvaises surprises.

    Latence.

    Bandwidth.

    VPN.

    DNS.

    Peering.

    Firewalls.

    Egress.

    Une architecture parfaitement conçue sur le papier peut fonctionner extrêmement mal si :

    une application cloud doit constamment interroger une base restée dans le datacenter.


    Mesurer avant de migrer

    Pour les applications sensibles :

    mesurez :

    • latence ;
    • volumes ;
    • nombre de connexions ;
    • dépendances ;
    • flux entrants ;
    • flux sortants.

    Une migration ne doit pas uniquement répondre à :

    “Est-ce que cela fonctionne ?”

    Mais aussi :

    “Est-ce que cela fonctionne avec les performances nécessaires ?”


    Erreur n°13 : oublier les coûts de transfert de données

    Imaginons une plateforme vidéo.

    Elle stocke :

    plusieurs pétaoctets.

    Et envoie énormément de données aux utilisateurs.

    Le coût principal n’est peut-être pas :

    le stockage.

    Mais :

    le transfert sortant.

    Les modèles tarifaires cloud possèdent énormément de dimensions.

    Il faut donc modéliser les workloads réels.

    Pas uniquement comparer :

    “Serveur actuel vs VM cloud.”


    Erreur n°14 : vouloir tout moderniser en même temps

    L’équipe migre.

    Puis décide :

    “Autant passer aux microservices.”

    Puis :

    “Et Kubernetes.”

    Puis :

    “Et une nouvelle base.”

    Puis :

    “Et changer le langage.”

    Puis :

    “Et refaire le frontend.”

    Résultat :

    le projet initial de migration devient :

    une réécriture complète du système.

    Le risque explose.


    Migration et modernisation ne sont pas la même chose

    Migration

    Changer d’environnement.

    Modernisation

    Modifier l’architecture ou la technologie.

    Les deux peuvent être combinés.

    Mais plus vous changez de variables simultanément, plus il devient difficile de comprendre la cause d’un problème.

    Microsoft recommande justement de planifier les modernisations en phases afin de limiter dérive budgétaire, scope creep et interruptions de service.


    Erreur n°15 : adopter une architecture trop complexe

    Le cloud rend des technologies sophistiquées très accessibles.

    Vous pouvez créer :

    • Kubernetes ;
    • Kafka ;
    • service mesh ;
    • multi-region ;
    • microservices ;
    • serverless ;
    • event streaming.

    En quelques jours.

    Cela ne signifie pas que vous devriez.

    Une PME peut transformer une application relativement simple en architecture nécessitant :

    quatre ingénieurs supplémentaires.

    La technologie est impressionnante.

    Le ROI :

    beaucoup moins.


    La règle de simplicité

    Avant d’adopter un composant, demandez :

    Quel problème précis résout-il ?

    Puis :

    Quelle serait la solution la plus simple capable de résoudre ce problème ?

    Cette question permet d’éviter énormément de sur-ingénierie.


    Erreur n°16 : tout miser sur une seule personne

    Vous avez recruté :

    “l’expert AWS”.

    Il construit :

    • infrastructure ;
    • réseau ;
    • pipelines ;
    • sécurité.

    Tout fonctionne.

    Puis il part.

    Personne ne comprend vraiment :

    • l’architecture ;
    • les scripts ;
    • les choix.

    Vous venez de créer un :

    bus factor = 1.


    Documenter et partager

    Une bonne plateforme cloud doit posséder :

    • documentation ;
    • diagrammes ;
    • runbooks ;
    • procédures ;
    • standards ;
    • repositories accessibles.

    Plusieurs personnes doivent comprendre les composants critiques.


    Erreur n°17 : oublier les sauvegardes parce que “c’est dans le cloud”

    C’est une idée reçue extrêmement dangereuse.

    Un fournisseur cloud peut fournir une infrastructure très fiable.

    Mais cela ne vous protège pas nécessairement contre :

    • suppression accidentelle ;
    • erreur applicative ;
    • ransomware ;
    • corruption ;
    • erreur humaine.

    Il faut distinguer :

    haute disponibilité

    et :

    backup.

    Ce ne sont pas la même chose.


    Tester les restaurations

    Le pire moment pour découvrir qu’une sauvegarde ne fonctionne pas est :

    pendant l’incident.

    Il faut donc tester régulièrement :

    • restore ;
    • RPO ;
    • RTO.

    RPO et RTO expliqués simplement

    RPO

    Combien de données pouvez-vous accepter de perdre ?

    Exemple :

    15 minutes.

    RTO

    Combien de temps pouvez-vous rester indisponible ?

    Exemple :

    2 heures.

    Ces objectifs doivent être décidés avec le métier.

    Pas uniquement par l’IT.


    Erreur n°18 : ne pas prévoir de rollback

    Vendredi 18 h.

    L’équipe bascule une application critique.

    Problème.

    Elle ne fonctionne plus correctement.

    Question :

    Comment revenir en arrière ?

    Silence.

    Une migration sérieuse doit toujours posséder :

    • critères de succès ;
    • critères d’échec ;
    • plan de rollback.

    Microsoft recommande explicitement de documenter les procédures de rollback et les critères de succès avant chaque cutover.


    Erreur n°19 : faire le big bang

    L’entreprise veut tout migrer en :

    6 mois.

    200 applications.

    Même weekend.

    C’est extrêmement risqué.

    Pourquoi ?

    Parce que les erreurs sont inévitables.

    Mais lorsque tout est migré simultanément, les erreurs se combinent.


    Préférer les vagues progressives

    Commencez par :

    vague 0

    tests.

    vague 1

    applications simples.

    vague 2

    applications internes.

    vague 3

    systèmes plus critiques.

    À chaque vague :

    apprendre.

    Corriger.

    Standardiser.

    La qualité augmente progressivement.


    Erreur n°20 : ne pas tester suffisamment avant le cutover

    Une application peut parfaitement fonctionner en environnement de test.

    Puis échouer en production.

    Pourquoi ?

    Parce que :

    • volume différent ;
    • utilisateurs différents ;
    • données différentes ;
    • réseau différent ;
    • charge différente.

    Il faut donc tester :

    Fonctionnel

    Est-ce que l’application marche ?

    Performance

    Supporte-t-elle la charge ?

    Sécurité

    Les contrôles sont-ils corrects ?

    Disaster Recovery

    Peut-on restaurer ?

    Utilisateurs

    Les workflows fonctionnent-ils ?


    Erreur n°21 : ne pas prévoir l’observabilité

    Vous migrez.

    Puis :

    l’application ralentit.

    Pourquoi ?

    Personne ne sait.

    Parce que vous n’avez pas :

    • métriques ;
    • logs centralisés ;
    • traces ;
    • alertes.

    Dans une architecture distribuée, l’observabilité devient encore plus importante.


    Monitoring vs observabilité

    Le monitoring demande :

    “Le serveur est-il disponible ?”

    L’observabilité cherche plutôt à répondre :

    “Pourquoi le système se comporte-t-il ainsi ?”

    Dans le cloud moderne, il faut souvent analyser :

    • application ;
    • base ;
    • réseau ;
    • API ;
    • dépendances.

    Erreur n°22 : migrer sans parler aux utilisateurs

    L’équipe IT travaille pendant huit mois.

    Migration réussie.

    Puis les utilisateurs découvrent :

    • nouvelle connexion ;
    • nouvelles procédures ;
    • performances différentes ;
    • interruptions.

    Ils sont furieux.

    Pourquoi ?

    Parce que personne ne leur avait expliqué le changement.

    Une migration possède aussi une dimension :

    change management.


    Identifier les parties prenantes

    Avant la migration :

    • métiers ;
    • direction ;
    • utilisateurs ;
    • finance ;
    • sécurité ;
    • juridique ;
    • support.

    Doivent comprendre :

    • ce qui change ;
    • quand ;
    • pourquoi ;
    • avec quel impact.

    Erreur n°23 : ne pas prendre la conformité suffisamment tôt

    Vous migrez des données.

    Puis le département juridique demande :

    “Dans quel pays sont-elles stockées ?”

    Réponse :

    silence.

    Ou pire :

    “On va vérifier.”

    Pour certaines données, la localisation et les modalités de traitement sont critiques.

    Il faut donc identifier :

    • données personnelles ;
    • données financières ;
    • données de santé ;
    • obligations contractuelles.

    La conformité doit être intégrée à l’architecture.


    Erreur n°24 : penser “multicloud” avant même de maîtriser un cloud

    Certaines organisations décident :

    “Nous devons être multicloud pour éviter le lock-in.”

    Puis créent simultanément :

    AWS.

    Azure.

    Google Cloud.

    Résultat :

    • 3 modèles IAM ;
    • 3 facturations ;
    • 3 réseaux ;
    • 3 catalogues ;
    • compétences multipliées.

    Le lock-in diminue peut-être.

    La complexité explose.


    Quand le multicloud est pertinent

    Par exemple :

    • contraintes réglementaires ;
    • acquisitions ;
    • besoins technologiques spécifiques ;
    • stratégies commerciales.

    Mais pas simplement :

    “Parce que c’est mieux.”


    Erreur n°25 : vouloir éliminer tout vendor lock-in

    L’autre extrême existe aussi.

    L’entreprise refuse :

    • base managée ;
    • serverless ;
    • services IA ;
    • services propriétaires.

    Pourquoi ?

    “Nous devons pouvoir changer de fournisseur demain.”

    Résultat :

    elle reconstruit elle-même énormément de services.

    Le coût augmente.

    La vitesse diminue.


    Le lock-in est un arbitrage

    Demandez :

    Quel est le coût réel d’un changement de fournisseur ?

    Quelle probabilité avons-nous de changer ?

    Quelle valeur le service propriétaire nous apporte-t-il ?

    Puis décidez.

    Le lock-in n’est pas automatiquement mauvais.

    Un lock-in inconscient l’est beaucoup plus.


    Erreur n°26 : ne pas prévoir les coûts après la migration

    Certaines entreprises établissent un business case avant.

    Puis ne le regardent plus jamais.

    La migration arrive.

    Le cloud fonctionne.

    La facture augmente.

    Mais personne ne compare :

    prévision vs réel.


    Créer une revue mensuelle

    Quelques métriques :

    Budget

    Prévu vs réel.

    Waste

    Ressources sous-utilisées.

    Unit economics

    Coût par utilisateur.

    Top services

    Qu’est-ce qui consomme le plus ?

    Evolution

    Pourquoi la facture a-t-elle augmenté ?

    La gestion des coûts doit être continue. Microsoft recommande d’ailleurs un suivi central et par workload plutôt qu’un contrôle ponctuel.


    Erreur n°27 : considérer la migration comme terminée après le cutover

    L’application est dans le cloud.

    Projet terminé ?

    Non.

    Commence maintenant :

    l’optimisation.

    Vous devez :

    • ajuster les ressources ;
    • analyser les performances ;
    • automatiser ;
    • améliorer la sécurité ;
    • optimiser les coûts ;
    • supprimer l’ancien environnement.

    La migration n’est donc pas une destination.

    C’est souvent le début d’un nouveau modèle opérationnel.


    Erreur n°28 : conserver l’ancien environnement trop longtemps

    Migration terminée.

    Mais personne n’ose arrêter l’ancien datacenter.

    Pendant :

    3 mois.

    Puis :

    6 mois.

    Vous payez :

    cloud + infrastructure historique.

    La migration devient extrêmement coûteuse.


    Préparer le decommissioning

    Dès le plan initial :

    définissez :

    quand arrêter l’ancien environnement ;

    qui valide ;

    comment archiver les données ;

    comment supprimer les accès.

    Sinon, les anciennes infrastructures peuvent survivre pendant des années.


    Les 5 erreurs qui coûtent généralement le plus cher

    Toutes les erreurs ne possèdent pas le même impact.

    Voici celles qui peuvent être particulièrement coûteuses.

    1. Migrer sans business case

    Vous ne savez pas si la transformation crée de la valeur.

    2. Lift and shift sans optimisation

    Facture cloud très importante.

    3. Mauvaise gouvernance

    Cloud sprawl.

    4. Mauvaises permissions

    Risque de sécurité.

    5. Sous-estimer les dépendances

    Incidents et retards.


    La méthode en 8 étapes pour éviter les erreurs

    Étape 1 — Définir le “pourquoi”

    Objectifs.

    KPIs.

    Budget.


    Étape 2 — Découvrir

    Inventaire.

    Dépendances.

    Criticité.


    Étape 3 — Classer

    Pour chaque application :

    • rehost ;
    • replatform ;
    • refactor ;
    • replace ;
    • retire ;
    • retain.

    Étape 4 — Construire les fondations

    Avant les workloads :

    • identité ;
    • réseau ;
    • sécurité ;
    • gouvernance ;
    • monitoring ;
    • coûts.

    Étape 5 — Faire un pilote

    Choisissez une application représentative.

    Pas la plus critique.


    Étape 6 — Migrer par vagues

    Petites vagues.

    Feedback.

    Amélioration.


    Étape 7 — Mesurer

    Coût.

    Performance.

    Disponibilité.

    Vitesse.


    Étape 8 — Optimiser

    Right-sizing.

    Automatisation.

    Services managés.

    Suppression des ressources inutiles.


    Checklist avant chaque migration

    Business

    • L’objectif est clair.
    • Le sponsor est identifié.
    • Le ROI ou business case est défini.
    • Les KPI sont mesurés avant migration.

    Application

    • Le propriétaire est connu.
    • La criticité est définie.
    • Les dépendances sont cartographiées.
    • Le volume de données est connu.

    Infrastructure

    • CPU et mémoire actuels sont mesurés.
    • Le réseau est analysé.
    • Le stockage est dimensionné.
    • Les flux entrants/sortants sont connus.

    Sécurité

    • IAM défini.
    • Principe du moindre privilège appliqué.
    • Données sensibles identifiées.
    • Chiffrement prévu.
    • Logs activés.

    Résilience

    • RPO défini.
    • RTO défini.
    • Backup prévu.
    • Restore testé.
    • Rollback défini.

    Finances

    • Coût estimé.
    • Budget défini.
    • Tags définis.
    • Alertes de coûts configurées.

    Organisation

    • Rôles définis.
    • Équipe formée.
    • Support préparé.
    • Utilisateurs informés.

    Si plusieurs de ces éléments restent inconnus :

    vous n’êtes probablement pas encore prêt à migrer.


    Exemple : une migration qui semble simple mais ne l’est pas

    Une PME possède :

    un ERP.

    Une base SQL.

    Un serveur de fichiers.

    Un portail client.

    Objectif :

    “Tout passer dans Azure.”

    L’entreprise déplace d’abord l’ERP.

    Mais découvre que :

    le portail client communique avec lui toutes les quelques secondes.

    Le portail reste on-premise.

    Latence.

    Performance dégradée.

    Puis :

    les utilisateurs se plaignent.

    L’équipe augmente les ressources cloud.

    Coût supérieur.

    Mais le problème était :

    le réseau et l’architecture.

    La migration devient coûteuse simplement parce que les dépendances n’avaient pas été suffisamment cartographiées.


    Ce qu’aurait dû faire l’entreprise

    1. cartographier ERP ↔ portail ;
    2. mesurer les flux ;
    3. migrer les composants liés dans la même vague ;
    4. tester la latence ;
    5. prévoir rollback ;
    6. mesurer avant/après.

    L’erreur n’était donc pas :

    “Azure fonctionne mal.”

    Elle était :

    “la migration avait été pensée application par application alors que le système fonctionnait comme un ensemble.”


    Les questions que le dirigeant doit poser

    Un dirigeant n’a pas besoin de maîtriser Kubernetes ou Terraform.

    Mais il doit savoir poser les bonnes questions.

    Pourquoi migrons-nous ?

    Quelles applications allons-nous supprimer ?

    Quel sera le coût après migration ?

    Quel est notre scénario pessimiste ?

    Comment revenons-nous en arrière si cela échoue ?

    Qui contrôle la facture ?

    Qui possède chaque workload ?

    Quel est notre plus gros risque ?

    Comment avons-nous testé la sécurité ?

    Comment mesurerons-nous la réussite ?

    Ces questions peuvent éviter des décisions extrêmement coûteuses.


    Migration cloud : technique ou transformation d’entreprise ?

    La réponse est :

    les deux.

    Techniquement, vous déplacez :

    • applications ;
    • données ;
    • infrastructure.

    Mais organisationnellement, vous changez aussi :

    • responsabilités ;
    • compétences ;
    • budget ;
    • rythme de travail ;
    • mode d’exploitation.

    C’est précisément pourquoi les migrations uniquement pilotées comme des projets IT peuvent parfois sous-performer.

    La finance doit être impliquée.

    La sécurité.

    Les métiers.

    La direction.


    Le rôle de la finance

    Avant :

    les serveurs sont achetés.

    Le coût est relativement prévisible.

    Avec le cloud :

    la consommation peut changer chaque jour.

    La finance doit donc évoluer vers :

    • prévisions ;
    • suivi ;
    • unit economics ;
    • FinOps.

    Le rôle de la sécurité

    Avant :

    protéger le périmètre.

    Avec le cloud :

    les identités deviennent particulièrement importantes.

    Qui peut :

    • accéder ;
    • modifier ;
    • créer ;
    • supprimer ?

    Le rôle des développeurs

    Ils peuvent obtenir beaucoup plus d’autonomie.

    Mais cette autonomie doit être encadrée par :

    • politiques ;
    • budgets ;
    • standards.

    La maturité cloud : trois étapes fréquentes

    Niveau 1 — Migration

    “Mettons les applications dans le cloud.”

    Niveau 2 — Optimisation

    “Utilisons mieux le cloud.”

    Niveau 3 — Transformation

    “Comment le cloud peut-il changer la manière dont nous développons et exploitons nos produits ?”

    C’est généralement au troisième niveau que la valeur potentielle devient la plus intéressante.


    Comment mesurer si la migration a réussi ?

    Une migration n’est pas réussie simplement parce que :

    tous les serveurs ont été déplacés.

    Mesurez plutôt :

    Coût

    Prévu vs réel.

    Disponibilité

    Avant vs après.

    Performance

    Avant vs après.

    Temps de déploiement

    Avant vs après.

    Fréquence de déploiement

    Avant vs après.

    Incidents

    Nombre et gravité.

    Temps de restauration

    MTTR.

    Productivité

    Temps nécessaire pour créer un environnement.

    Business

    Time-to-market.

    Conversion.

    Revenus.

    Toutes les métriques ne seront pas pertinentes dans toutes les entreprises.

    Mais il faut mesurer quelque chose.


    Conclusion : une migration cloud réussie n’est pas un déménagement

    L’erreur la plus profonde consiste probablement à penser :

    “Nous déplaçons notre informatique dans un autre datacenter.”

    Le cloud est beaucoup plus que cela.

    Il change :

    la façon dont les ressources sont consommées.

    la façon dont elles sont payées.

    la manière dont les équipes travaillent.

    la manière dont la sécurité est gérée.

    la vitesse à laquelle l’infrastructure peut évoluer.

    Et chaque avantage apporte aussi un nouveau risque.

    La facilité de création de ressources apporte :

    du cloud sprawl.

    Le paiement à l’usage apporte :

    une facture variable.

    L’autonomie apporte :

    un besoin de gouvernance.

    Les services managés apportent :

    de nouvelles dépendances.

    La flexibilité apporte :

    de la complexité.

    Cela ne signifie pas que le cloud est une mauvaise décision.

    Au contraire.

    Il peut devenir un formidable accélérateur.

    Mais uniquement lorsqu’il est traité comme :

    une transformation business et opérationnelle, pas simplement comme un projet de déménagement informatique.

    La question ne devrait donc jamais être uniquement :

    “Quand aurons-nous terminé la migration ?”

    Il faut aussi demander :

    “À quoi ressemblera notre entreprise lorsqu’elle sera terminée ?”

    Si les équipes :

    • déploient plus rapidement ;
    • disposent d’une infrastructure plus résiliente ;
    • comprennent leurs coûts ;
    • automatisent davantage ;
    • innovent plus vite ;

    alors la migration crée réellement de la valeur.

    Mais si vous obtenez simplement :

    les mêmes applications, les mêmes processus, les mêmes problèmes et une nouvelle facture mensuelle…

    vous n’avez probablement pas transformé votre entreprise.

    Vous avez simplement changé l’adresse de vos serveurs.


    Vous préparez une migration cloud et voulez éviter les erreurs qui coûtent cher ?

    Une migration cloud ne devrait pas commencer par une technologie.

    Elle devrait commencer par :

    un objectif, un business case et une stratégie.

    Chez Tommy Montégu Conseil, nous accompagnons les entrepreneurs, startups et dirigeants qui souhaitent structurer leur croissance et prendre de meilleures décisions sur leurs investissements.

    Dans le cadre d’un projet cloud ou technologique, cette réflexion peut notamment concerner :

    • le business case ;
    • les coûts ;
    • les priorités ;
    • les risques ;
    • la stratégie de migration ;
    • l’organisation ;
    • la rentabilité ;
    • la scalabilité ;
    • les indicateurs de performance.

    Parce qu’une migration réussie n’est pas celle où :

    100 % des serveurs sont dans le cloud.

    C’est celle où la technologie permet réellement à l’entreprise de devenir :

    plus rapide, plus robuste, mieux organisée et économiquement plus performante.
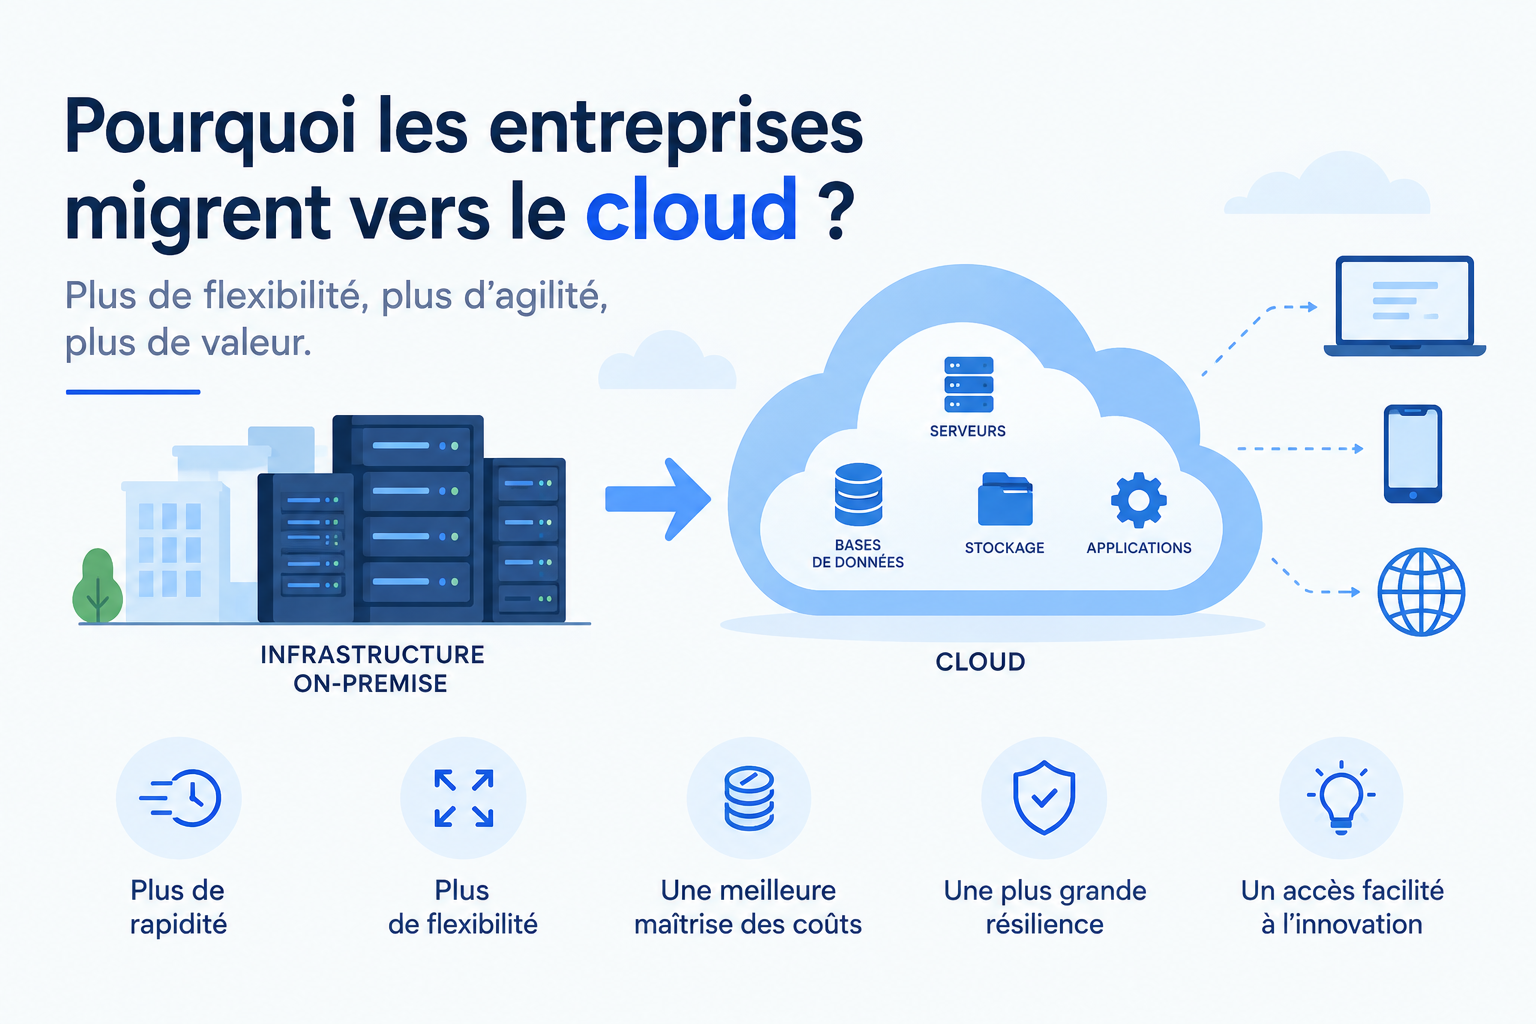
  • Pourquoi les entreprises migrent vers le cloud : avantages, risques et stratégie de migration.

    Pourquoi les entreprises migrent vers le cloud : avantages, risques et stratégie de migration.


    Il y a encore quelques années, lorsqu’une entreprise avait besoin d’un nouveau serveur, le processus pouvait ressembler à ceci :

    Elle estimait ses futurs besoins.

    Elle commandait du matériel.

    Elle attendait sa livraison.

    Elle installait le serveur.

    Elle configurait le réseau.

    Elle installait les logiciels.

    Puis elle espérait avoir correctement anticipé la capacité nécessaire pour les trois prochaines années.

    Si elle avait prévu trop grand, elle payait pour des ressources inutilisées.

    Si elle avait prévu trop petit, elle devait recommencer.

    Aujourd’hui, le scénario peut être totalement différent.

    Une entreprise a besoin de davantage de puissance informatique.

    Quelques minutes plus tard, elle peut provisionner :

    • de nouveaux serveurs ;
    • du stockage ;
    • une base de données ;
    • des capacités de calcul ;
    • des services d’intelligence artificielle.

    Puis réduire ces ressources lorsque le besoin disparaît.

    C’est l’une des promesses fondamentales du cloud computing.

    Mais elle n’explique qu’une partie de la transformation.

    Car si autant d’entreprises migrent aujourd’hui vers le cloud, ce n’est pas simplement pour arrêter d’acheter des serveurs.

    Elles cherchent également à devenir :

    plus rapides, plus flexibles, plus résilientes et parfois plus innovantes.

    Selon la définition de référence du National Institute of Standards and Technology, le cloud computing permet d’accéder à la demande, via le réseau, à un ensemble partagé de ressources informatiques configurables qui peuvent être rapidement fournies et libérées avec un effort de gestion limité. Le NIST retient notamment cinq grandes caractéristiques : libre-service à la demande, accès réseau, mutualisation des ressources, élasticité rapide et service mesuré.

    En langage simple :

    Le cloud permet à une entreprise de consommer de l’informatique davantage comme un service que comme un ensemble de machines qu’elle doit acheter et exploiter elle-même.

    Et cette différence change énormément de choses.


    Qu’est-ce que le cloud computing exactement ?

    Commençons par éliminer une idée reçue.

    Le cloud n’est pas réellement “dans les nuages”.

    Les données et applications fonctionnent toujours sur :

    • des serveurs ;
    • des disques ;
    • des réseaux ;
    • des datacenters.

    La grande différence est principalement :

    qui possède et exploite l’infrastructure, comment l’entreprise y accède et comment elle la paie.

    Dans un modèle traditionnel, l’entreprise peut acheter :

    • ses serveurs ;
    • ses équipements réseau ;
    • son stockage.

    Elle les installe dans ses locaux ou dans un datacenter.

    On parle souvent d’infrastructure :

    on-premise ou on-premises.

    Avec le cloud, une partie de ces ressources peut être fournie à distance par un prestataire.

    Parmi les acteurs les plus connus :

    • Amazon Web Services ;
    • Microsoft Azure ;
    • Google Cloud.

    Mais il existe évidemment de nombreux autres fournisseurs.


    Une analogie simple : acheter une centrale électrique ou acheter de l’électricité

    Imaginez que chaque entreprise doive produire elle-même son électricité.

    Elle devrait :

    • acheter des générateurs ;
    • les entretenir ;
    • prévoir les pics de consommation ;
    • conserver des pièces détachées ;
    • embaucher des spécialistes.

    Cela serait extrêmement lourd.

    À la place, la majorité des entreprises utilisent simplement le réseau électrique.

    Elles consomment ce dont elles ont besoin.

    L’infrastructure complexe reste principalement chez le fournisseur.

    Le cloud applique une logique assez comparable à l’informatique.

    Au lieu de posséder nécessairement toute l’infrastructure :

    l’entreprise consomme une capacité informatique fournie comme un service.

    Cette analogie n’est évidemment pas parfaite, mais elle permet de comprendre le changement de modèle.


    Les trois grands modèles : IaaS, PaaS et SaaS

    Le NIST distingue trois grands modèles de services cloud : IaaS, PaaS et SaaS.

    Voyons-les simplement.


    IaaS : Infrastructure as a Service

    Le fournisseur vous apporte essentiellement :

    • machines virtuelles ;
    • stockage ;
    • réseau ;
    • capacité de calcul.

    Mais votre entreprise continue à gérer une partie importante du système.

    Par exemple :

    • système d’exploitation ;
    • applications ;
    • configurations.

    C’est comme louer une cuisine professionnelle vide.

    Le bâtiment existe.

    L’électricité fonctionne.

    Mais vous devez toujours organiser votre cuisine.


    PaaS : Platform as a Service

    Le fournisseur gère davantage de choses.

    Vous vous concentrez principalement sur :

    • votre application ;
    • votre code ;
    • vos données.

    Une partie importante de l’infrastructure technique est abstraite.

    C’est comme louer une cuisine déjà équipée et entretenue.

    Vous cuisinez.

    Le propriétaire gère une grande partie du reste.


    SaaS : Software as a Service

    Ici, vous utilisez directement le logiciel final.

    Exemples typiques :

    • messagerie professionnelle ;
    • CRM ;
    • outils collaboratifs ;
    • logiciels de gestion.

    L’entreprise n’administre généralement ni les serveurs ni la plateforme sous-jacente.

    Elle utilise simplement le service.


    Vous utilisez probablement déjà le cloud sans vous en rendre compte

    Une PME qui utilise :

    • un CRM en ligne ;
    • Google Workspace ou Microsoft 365 ;
    • un logiciel de facturation accessible via navigateur ;
    • Dropbox ;
    • Slack ;
    • un logiciel RH en SaaS ;

    utilise déjà des services cloud.

    Migrer vers le cloud ne signifie donc pas nécessairement déplacer un gigantesque datacenter.

    Pour une petite entreprise, cela peut simplement vouloir dire :

    remplacer plusieurs logiciels installés localement par des solutions accessibles en ligne.


    Cloud public, cloud privé et cloud hybride

    Autre distinction importante.

    Le cloud n’existe pas sous une seule forme.

    Le NIST distingue notamment plusieurs modèles de déploiement, parmi lesquels le cloud public, privé et hybride.


    Cloud public

    L’infrastructure appartient à un fournisseur de services cloud.

    Plusieurs clients utilisent les capacités du fournisseur avec une séparation logique entre leurs environnements.

    Avantages potentiels :

    • grande flexibilité ;
    • déploiement rapide ;
    • immense catalogue de services ;
    • investissement initial limité.

    Cloud privé

    L’environnement cloud est réservé à une seule organisation.

    Il peut être exploité :

    • directement par l’entreprise ;
    • par un prestataire.

    L’objectif peut être d’obtenir certains avantages du cloud tout en conservant davantage de contrôle.


    Cloud hybride

    L’entreprise combine plusieurs environnements.

    Par exemple :

    • certaines applications restent dans son datacenter ;
    • d’autres passent dans le cloud public.

    Elle peut aussi connecter cloud privé et cloud public.

    C’est extrêmement fréquent dans les grandes organisations.

    Pourquoi ?

    Parce qu’une migration complète en une seule fois est rarement réaliste.


    Et le multicloud ?

    Le multicloud consiste à utiliser plusieurs fournisseurs cloud.

    Par exemple :

    • certains workloads chez AWS ;
    • d’autres chez Azure ;
    • d’autres services chez Google Cloud.

    Cela peut permettre :

    • d’utiliser les meilleurs services de chaque fournisseur ;
    • de répondre à certaines contraintes ;
    • de diversifier certains risques.

    Mais cela ajoute également beaucoup de complexité.

    Multicloud ne signifie donc pas automatiquement :

    meilleure stratégie cloud.


    Pourquoi les entreprises migrent-elles vers le cloud ?

    Les motivations varient énormément.

    Une startup de dix personnes n’a pas les mêmes raisons qu’une banque internationale.

    Mais plusieurs motivations reviennent régulièrement.


    1. Pour gagner énormément en vitesse

    C’est probablement l’un des bénéfices les plus importants.

    Imaginez une entreprise traditionnelle.

    Elle veut tester une nouvelle application.

    Elle doit peut-être :

    1. définir les besoins ;
    2. obtenir un budget ;
    3. commander un serveur ;
    4. attendre ;
    5. installer ;
    6. configurer ;
    7. sécuriser ;
    8. déployer.

    Cela peut prendre des semaines.

    Dans le cloud :

    les ressources peuvent parfois être créées en quelques minutes.

    Cette vitesse change profondément la capacité d’une entreprise à expérimenter.

    Un développeur peut :

    • créer un environnement ;
    • tester ;
    • mesurer ;
    • supprimer l’environnement.

    Le coût de l’expérimentation diminue.


    2. Pour ne plus dimensionner l’infrastructure plusieurs années à l’avance

    C’est l’un des grands problèmes de l’informatique traditionnelle.

    Supposons que votre entreprise possède actuellement :

    100 000 utilisateurs.

    Vous pensez atteindre :

    500 000 utilisateurs dans trois ans.

    Quelle infrastructure achetez-vous aujourd’hui ?

    Celle pour :

    100 000 ?

    Vous risquez de manquer de capacité.

    Celle pour :

    500 000 ?

    Vous payez maintenant pour des ressources inutilisées.

    Le cloud change cette logique.

    Vous pouvez démarrer avec une capacité limitée.

    Puis l’augmenter lorsque le besoin apparaît.

    C’est le principe d’élasticité, l’une des caractéristiques essentielles du cloud retenues par le NIST.


    3. Pour absorber plus facilement les pics de trafic

    Imaginez un e-commerce.

    Trafic habituel :

    20 000 visiteurs par jour.

    Black Friday :

    400 000 visiteurs.

    Dans une infrastructure traditionnelle, il faudrait potentiellement posséder toute l’année une infrastructure capable de gérer le Black Friday.

    Cela signifie qu’elle serait largement sous-utilisée le reste du temps.

    Avec une architecture cloud correctement conçue, la capacité peut augmenter pendant le pic puis diminuer ensuite.

    Attention cependant :

    le scaling n’est pas automatique simplement parce qu’une application est hébergée dans le cloud.

    L’application et l’architecture doivent être conçues correctement.


    4. Pour transformer une partie des investissements en dépenses variables

    Historiquement, une infrastructure informatique demandait souvent un important investissement initial.

    Vous achetiez :

    • serveurs ;
    • stockage ;
    • réseau ;
    • licences ;
    • équipements.

    Puis vous amortissiez ces investissements.

    Le cloud permet davantage un modèle :

    pay-as-you-go.

    Vous consommez.

    Puis vous payez en fonction de certains usages.

    Cette caractéristique de service mesuré fait partie de la définition du cloud du NIST.

    Cela permet notamment de réduire certaines barrières à l’entrée.

    Une startup n’a pas besoin d’acheter un datacenter avant d’obtenir ses premiers clients.


    Mais attention : cloud ne signifie pas automatiquement moins cher

    C’est probablement l’un des mythes les plus importants.

    Beaucoup d’entreprises migrent en pensant :

    “Le cloud va faire baisser notre facture informatique.”

    Parfois oui.

    Parfois non.

    Et parfois la facture augmente considérablement.

    Pourquoi ?

    Parce que la facilité d’utilisation du cloud possède un revers.

    Créer une ressource est facile.

    L’oublier est également facile.

    Une entreprise peut accumuler :

    • machines inutilisées ;
    • stockage oublié ;
    • environnements de test ;
    • bases surdimensionnées ;
    • services non arrêtés.

    La gestion des coûts cloud est devenue un sujet stratégique à part entière.

    Selon le State of the Cloud 2026 de Flexera, 85 % des répondants considèrent la maîtrise des coûts cloud comme leur principal défi et estiment en moyenne que 29 % des dépenses IaaS/PaaS sont gaspillées. Ces chiffres proviennent d’une enquête d’un fournisseur de solutions de gestion technologique et doivent donc être considérés comme un indicateur du marché plutôt que comme une mesure universelle de toutes les entreprises.


    Le cloud change donc la nature du problème financier

    Avant :

    “Avons-nous acheté trop de serveurs ?”

    Maintenant :

    “Consommons-nous trop de ressources ?”

    C’est une différence importante.

    Les entreprises développent donc de plus en plus des pratiques de :

    FinOps.

    L’objectif est de rapprocher :

    • finance ;
    • ingénierie ;
    • produit ;
    • cloud.

    Pour répondre à une question simple :

    Quelle valeur business obtenons-nous pour chaque euro dépensé dans le cloud ?


    5. Pour accélérer le lancement de nouveaux produits

    Imaginons deux entreprises concurrentes.

    Entreprise A

    Pour tester une nouvelle application :

    2 mois d’infrastructure.

    Entreprise B

    Pour tester :

    2 jours.

    Même si les deux possèdent les mêmes développeurs, l’entreprise B peut réaliser davantage d’expériences.

    Sur plusieurs années, cette différence peut devenir considérable.

    Le véritable avantage du cloud n’est donc pas toujours :

    réduire les coûts informatiques.

    Il peut être :

    réduire le temps entre une idée et son test sur le marché.

    Et pour une startup, ce délai peut être extrêmement important.


    6. Pour accéder à des technologies qui seraient très coûteuses à construire soi-même

    Les grands clouds proposent aujourd’hui des centaines de services.

    Par exemple :

    • bases de données ;
    • machine learning ;
    • intelligence artificielle ;
    • analyse de données ;
    • traitement vidéo ;
    • reconnaissance d’images ;
    • traduction ;
    • stockage ;
    • cybersécurité ;
    • IoT.

    Une entreprise peut donc utiliser une infrastructure sophistiquée sans la reconstruire intégralement.

    Prenons une base de données.

    Construire une infrastructure complète autour d’une base distribuée demande :

    • compétences ;
    • backups ;
    • réplication ;
    • monitoring ;
    • mises à jour.

    Un service managé peut prendre en charge une partie importante de ces tâches.


    7. Pour réduire une partie du travail d’administration

    C’est une évolution extrêmement importante.

    Prenons une base de données traditionnelle.

    L’équipe doit potentiellement gérer :

    • serveur ;
    • système d’exploitation ;
    • patches ;
    • sauvegardes ;
    • haute disponibilité ;
    • monitoring.

    Avec une base de données managée, le fournisseur peut prendre en charge une partie de ces responsabilités.

    L’équipe interne peut alors consacrer davantage de temps à :

    la valeur métier.

    Par exemple :

    développer la fonctionnalité que le client utilisera.

    Plutôt que :

    mettre à jour un serveur.


    8. Pour améliorer la résilience

    Une entreprise moderne dépend énormément de son système informatique.

    Une panne peut :

    • arrêter les commandes ;
    • bloquer les salariés ;
    • empêcher les paiements ;
    • rendre un service inaccessible.

    Les grands fournisseurs cloud possèdent généralement plusieurs :

    • régions ;
    • datacenters ;
    • zones de disponibilité.

    Une architecture correctement conçue peut donc répartir les services sur plusieurs emplacements.

    Si un composant tombe, d’autres peuvent continuer.

    Mais il existe une nuance capitale :

    le cloud donne accès à des outils de résilience. Il ne rend pas automatiquement une application résiliente.

    Si vous déployez toute votre entreprise sur :

    • une seule machine ;
    • une seule zone ;
    • sans sauvegarde ;

    vous restez vulnérable.


    9. Pour améliorer les plans de reprise après sinistre

    Que se passe-t-il si :

    • un datacenter brûle ;
    • une machine critique tombe ;
    • des données sont corrompues ;
    • une attaque bloque l’infrastructure ?

    Les entreprises doivent prévoir un :

    Disaster Recovery Plan.

    Le cloud peut faciliter la création :

    • de sauvegardes distribuées ;
    • d’environnements secondaires ;
    • de réplication ;
    • de restaurations automatisées.

    Mais là encore :

    avoir une sauvegarde n’est pas suffisant.

    Il faut tester régulièrement qu’elle peut réellement être restaurée.


    10. Pour soutenir le travail distribué

    La pandémie a montré à quel point l’accès à distance aux outils professionnels pouvait devenir critique.

    Une entreprise dont les ressources sont accessibles via des services cloud peut plus facilement permettre à ses collaborateurs de travailler :

    • depuis le bureau ;
    • depuis chez eux ;
    • depuis un autre pays.

    À condition évidemment que :

    • les droits d’accès ;
    • les identités ;
    • la sécurité ;

    soient correctement gérés.


    11. Pour faciliter l’expansion internationale

    Imaginez une startup française.

    Son application fonctionne à Paris.

    Puis elle veut servir :

    • les États-Unis ;
    • Singapour ;
    • l’Australie.

    Construire ses propres datacenters serait extrêmement coûteux.

    Avec le cloud, elle peut parfois utiliser des infrastructures déjà présentes dans différentes régions du monde.

    Cela peut aider à réduire :

    • latence ;
    • complexité d’expansion.

    Mais attention :

    la localisation des données et les réglementations doivent être analysées attentivement.


    12. Pour automatiser davantage l’infrastructure

    L’un des grands changements apportés par le cloud est la possibilité de gérer l’infrastructure comme du logiciel.

    On parle notamment :

    Infrastructure as Code.

    Au lieu qu’un ingénieur clique manuellement dans une interface pour créer :

    • serveurs ;
    • réseaux ;
    • bases ;

    il peut décrire l’infrastructure dans du code.

    Cela permet :

    • versioning ;
    • répétabilité ;
    • automatisation ;
    • audits ;
    • déploiements plus cohérents.

    Exemple

    Vous avez besoin de créer :

    un réseau ;

    trois serveurs ;

    une base ;

    un load balancer.

    Au lieu de tout configurer manuellement :

    vous exécutez une configuration automatisée.

    Le même environnement peut ensuite être recréé.

    C’est particulièrement puissant pour :

    • développement ;
    • test ;
    • production.

    13. Pour améliorer la standardisation

    Dans certaines entreprises anciennes, l’infrastructure ressemble à ceci :

    Serveur A :

    Ubuntu 18.

    Serveur B :

    Ubuntu 20.

    Serveur C :

    configuration inconnue.

    Serveur D :

    personne ne sait réellement ce qu’il fait.

    Cette accumulation constitue une dette technique.

    Une migration cloud peut devenir l’occasion de :

    • inventorier ;
    • standardiser ;
    • automatiser ;
    • supprimer les systèmes inutiles.

    La migration n’est donc pas seulement physique.

    Elle peut devenir un projet de modernisation.


    14. Pour faciliter l’accès à l’intelligence artificielle

    Depuis l’explosion de l’IA générative, cette motivation prend encore davantage d’importance.

    Les fournisseurs cloud proposent aujourd’hui :

    • GPU ;
    • modèles ;
    • API ;
    • plateformes de machine learning ;
    • outils de données ;
    • services spécialisés.

    Une entreprise souhaitant expérimenter avec l’IA peut donc accéder rapidement à des capacités de calcul qu’il serait extrêmement coûteux d’acheter pour une utilisation ponctuelle.

    Cela contribue également à la hausse des dépenses cloud observée ces dernières années.

    Flexera indique notamment que la croissance des workloads liés à l’IA contribue à la complexité croissante de la gestion des coûts cloud.


    15. Parce que le cloud permet parfois aux équipes techniques de se concentrer davantage sur le produit

    Imaginez une startup avec cinq développeurs.

    Chaque semaine, deux passent énormément de temps à :

    • réparer des serveurs ;
    • installer des mises à jour ;
    • gérer des sauvegardes ;
    • maintenir l’infrastructure.

    Ce temps n’est pas nécessairement perdu.

    Mais ce n’est pas le cœur de la différenciation de l’entreprise.

    Le cloud permet parfois d’acheter comme service certaines capacités génériques.

    Les développeurs peuvent alors consacrer davantage de temps à :

    ce qui rend réellement le produit unique.


    Migration cloud : les 6 grandes stratégies

    Toutes les migrations ne se ressemblent pas.

    Une classification classique distingue plusieurs approches.


    1. Rehost — déplacer presque tel quel

    On parle souvent de :

    lift and shift.

    L’application est déplacée vers le cloud sans modification majeure.

    Avantages :

    • rapide ;
    • relativement simple.

    Inconvénient :

    elle n’exploite pas nécessairement les avantages du cloud.


    Exemple

    Vous avez :

    10 machines virtuelles dans votre datacenter.

    Vous créez :

    10 machines virtuelles équivalentes dans le cloud.

    Techniquement :

    vous êtes dans le cloud.

    Architecturalement :

    presque rien n’a changé.


    2. Replatform — adapter partiellement

    Vous conservez la majeure partie de l’application.

    Mais vous remplacez certaines briques.

    Par exemple :

    avant :

    base MySQL gérée sur serveur interne.

    Après :

    base MySQL managée dans le cloud.

    Vous réduisez une partie du travail d’administration.


    3. Refactor / Rearchitect

    L’application est transformée plus profondément pour utiliser les capacités cloud.

    Par exemple :

    • microservices ;
    • serverless ;
    • services managés ;
    • architecture événementielle.

    Potentiel :

    élevé.

    Mais :

    coût et risque également élevés.


    4. Repurchase

    Vous remplacez l’application existante par un logiciel SaaS.

    Exemple :

    ancien CRM installé localement.

    Vous migrez vers un CRM cloud.

    Vous ne migrez donc pas réellement l’application.

    Vous la remplacez.


    5. Retire

    Pendant l’audit, vous découvrez que certaines applications ne servent plus à rien.

    Meilleure stratégie :

    les supprimer.

    Migrer une application inutile est probablement la migration la moins rentable.


    6. Retain

    Certaines applications restent là où elles sont.

    Pourquoi ?

    • réglementation ;
    • performance ;
    • coût ;
    • dépendances ;
    • matériel spécialisé.

    Une bonne stratégie cloud n’impose pas de tout migrer.


    Le meilleur projet cloud commence donc par une question

    Pas :

    “Comment tout migrer ?”

    Mais :

    “Qu’est-ce qui mérite réellement d’être migré ?”

    C’est très différent.


    Pourquoi certaines entreprises ne migrent-elles pas tout ?

    Parce que le cloud possède aussi des limites.


    Risque n°1 : les coûts peuvent exploser

    Le paiement à l’usage est formidable.

    Jusqu’à ce que l’usage augmente énormément.

    Prenons une application.

    Elle fonctionne 24 heures sur 24.

    Trafic parfaitement stable.

    Infrastructure très prévisible.

    Dans certains cas, posséder une infrastructure optimisée peut être moins coûteux sur plusieurs années.

    Le cloud n’est donc pas automatiquement le choix économique optimal pour tous les workloads.


    Le piège des petits coûts qui deviennent énormes

    Une ressource coûte :

    0,20 € par heure.

    Cela semble insignifiant.

    Mais :

    0,20 × 24 × 365 = environ 1 752 € par an.

    Maintenant multipliez par :

    500 ressources.

    Vous dépassez :

    876 000 € par an.

    Dans le cloud, les petites décisions techniques peuvent rapidement devenir de grandes décisions financières.


    Risque n°2 : les coûts de sortie de données

    Les entreprises regardent parfois uniquement :

    • calcul ;
    • stockage.

    Mais oublient :

    le réseau.

    Transférer beaucoup de données hors d’un cloud peut entraîner des coûts.

    Pour certains business très intensifs en données :

    • vidéo ;
    • streaming ;
    • analytics ;

    cela peut devenir significatif.


    Risque n°3 : le vendor lock-in

    Vous utilisez de plus en plus :

    • base propriétaire ;
    • fonctions serverless ;
    • IA propriétaire ;
    • services réseau spécifiques.

    Votre application devient profondément liée au fournisseur.

    Changer de cloud devient alors difficile.

    C’est ce qu’on appelle :

    vendor lock-in.

    Mais attention à une autre idée reçue :

    éviter absolument tout lock-in peut également coûter cher.

    Si vous refusez toutes les fonctions avancées du fournisseur uniquement pour rester parfaitement portable, vous pouvez perdre une partie de la valeur du cloud.

    La bonne question devient :

    Quel niveau de dépendance sommes-nous prêts à accepter en échange de quel avantage ?


    Risque n°4 : la sécurité ne disparaît pas

    Certaines entreprises pensent :

    “Nous sommes chez un grand cloud provider donc nous sommes sécurisés.”

    C’est faux.

    Les grands fournisseurs sécurisent leur infrastructure.

    Mais l’entreprise reste responsable de nombreuses choses :

    • utilisateurs ;
    • mots de passe ;
    • permissions ;
    • configurations ;
    • applications ;
    • données.

    C’est ce que l’on appelle souvent :

    shared responsibility model.


    Une mauvaise configuration peut être catastrophique

    Exemple :

    un bucket de stockage contenant des données sensibles.

    L’entreprise le configure accidentellement en accès public.

    Le fournisseur cloud fonctionne parfaitement.

    Mais la sécurité de l’entreprise est compromise.

    Le problème n’était pas le cloud.

    C’était :

    la configuration.


    Risque n°5 : la souveraineté et la localisation des données

    Toutes les données ne peuvent pas nécessairement être hébergées n’importe où.

    Selon :

    • secteur ;
    • pays ;
    • type de données ;
    • contrats ;

    l’entreprise peut avoir des obligations concernant :

    • stockage ;
    • traitement ;
    • transferts.

    En Europe, les réglementations concernant les données personnelles doivent évidemment être prises en compte.

    Une stratégie cloud sérieuse doit donc inclure :

    les équipes juridiques et conformité.

    Pas uniquement l’IT.


    Risque n°6 : migrer une mauvaise architecture ne la rend pas bonne

    C’est probablement le piège le plus important.

    Vous possédez une application lente.

    Difficile à maintenir.

    Mal conçue.

    Vous la déplacez dans le cloud.

    Résultat :

    une application lente, difficile à maintenir et mal conçue… dans le cloud.

    La migration n’efface pas la dette technique.

    Parfois, elle la rend simplement plus visible.


    Risque n°7 : la complexité augmente parfois

    Le cloud peut simplifier certaines choses.

    Mais il peut en complexifier d’autres.

    Une architecture moderne peut inclure :

    • Kubernetes ;
    • serverless ;
    • plusieurs bases ;
    • queues ;
    • API Gateway ;
    • IAM ;
    • observabilité ;
    • infrastructure as code.

    Le système devient extrêmement puissant.

    Mais également plus difficile à comprendre.

    Il faut donc toujours comparer :

    valeur créée

    contre :

    complexité introduite.


    Pourquoi certaines entreprises rapatrient-elles certains workloads ?

    Il existe aussi un phénomène appelé :

    cloud repatriation.

    Une entreprise déplace certaines applications du cloud vers :

    • datacenter privé ;
    • infrastructure dédiée.

    Pourquoi ?

    Parfois :

    • coûts ;
    • performance ;
    • réglementation ;
    • contrôle.

    Les données 2025 de Flexera indiquaient d’ailleurs que les organisations interrogées avaient rapatrié une partie de leurs workloads tout en continuant globalement à augmenter leur utilisation du cloud public.

    Cela montre quelque chose d’important :

    l’avenir n’est probablement pas “100 % cloud” pour tout le monde.

    Il est davantage :

    utiliser chaque type d’infrastructure là où il crée le plus de valeur.


    Le cloud hybride devient donc logique

    Imaginez une industrie.

    Elle possède :

    • systèmes industriels locaux ;
    • données critiques ;
    • ERP ;
    • e-commerce ;
    • analytics.

    Elle pourrait conserver :

    certaines fonctions localement.

    Et placer :

    • e-commerce ;
    • analytics ;
    • sauvegardes ;
    • applications collaboratives ;

    dans le cloud.

    L’architecture devient hybride.

    Ce n’est pas nécessairement une étape temporaire.

    Pour certaines organisations, cela peut être un modèle durable.


    Le cloud est-il plus écologique ?

    Question complexe.

    Les grands datacenters hyperscale peuvent être extrêmement optimisés en matière d’efficacité énergétique.

    Mutualiser les ressources peut théoriquement éviter des milliers de petits serveurs très sous-utilisés.

    Mais le cloud facilite également une explosion de la consommation informatique.

    IA.

    Streaming.

    Stockage.

    Calcul.

    Le bilan dépend donc :

    • de l’infrastructure ;
    • du fournisseur ;
    • de l’énergie ;
    • du taux d’utilisation ;
    • de l’architecture.

    Dire simplement :

    “Le cloud est écologique.”

    serait donc beaucoup trop simpliste.


    Comment savoir si votre entreprise doit migrer vers le cloud ?

    Voici quelques signaux.


    Signal 1 : votre infrastructure vous ralentit

    Il faut plusieurs semaines pour :

    • créer un environnement ;
    • ajouter des ressources ;
    • lancer une application.

    Le cloud peut apporter beaucoup de flexibilité.


    Signal 2 : votre trafic varie fortement

    Vous avez :

    • pics saisonniers ;
    • campagnes ;
    • événements.

    L’élasticité devient intéressante.


    Signal 3 : vous dépensez énormément de temps sur des infrastructures génériques

    Vos équipes passent plus de temps à :

    maintenir des serveurs

    qu’à :

    développer votre produit.

    Des services managés peuvent avoir beaucoup de valeur.


    Signal 4 : votre matériel arrive en fin de vie

    Vous devez prochainement investir massivement dans :

    • serveurs ;
    • stockage ;
    • datacenter.

    C’est souvent un moment logique pour comparer les scénarios.


    Signal 5 : vous ouvrez de nouveaux marchés

    Vous avez besoin d’une infrastructure dans plusieurs zones géographiques.

    Le cloud peut accélérer l’expansion.


    Signal 6 : vous voulez accélérer l’innovation

    IA.

    Data.

    Machine learning.

    Expérimentation.

    Le cloud donne accès rapidement à des services complexes.


    Mais quand ne faut-il probablement pas migrer immédiatement ?

    Si votre système :

    • fonctionne très bien ;
    • possède une charge stable ;
    • coûte peu ;
    • n’évolue presque pas ;
    • ne limite pas l’activité ;

    une migration peut créer davantage de risques que de bénéfices.

    Le simple fait qu’une technologie soit moderne ne constitue pas une justification économique.


    La grande erreur : calculer seulement le coût des serveurs

    Supposons :

    Infrastructure actuelle :

    100 000 €/an.

    Cloud estimé :

    80 000 €/an.

    Conclusion :

    “Nous économisons 20 000 €.”

    Pas si vite.

    Il faut intégrer :

    Migration

    Combien coûtera le projet ?

    Formation

    Les équipes possèdent-elles les compétences ?

    Réécriture

    Certaines applications doivent-elles évoluer ?

    Réseau

    Quels nouveaux coûts ?

    Sécurité

    Quels outils supplémentaires ?

    Support

    Quel niveau de contrat ?

    Exploitation

    Combien coûtera la gestion ?

    C’est ce qu’on appelle :

    Total Cost of Ownership — TCO.


    Le cloud doit également être évalué par la valeur

    Imaginons :

    Infrastructure traditionnelle :

    500 000 € par an.

    Cloud :

    600 000 €.

    À première vue :

    mauvaise décision.

    Mais grâce au cloud :

    vous passez de :

    4 lancements par an

    à :

    Et vous gagnez :

    3 millions d’euros supplémentaires.

    Le cloud coûte davantage.

    Mais il crée beaucoup plus de valeur.

    C’est pourquoi la réflexion cloud ne doit pas se réduire à :

    “Quel serveur coûte le moins cher ?”


    Le ROI du cloud peut venir de plusieurs endroits

    Réduction des investissements

    Moins de matériel à acheter.

    Productivité

    Moins de maintenance manuelle.

    Time-to-market

    Produits lancés plus rapidement.

    Résilience

    Moins d’interruptions.

    Innovation

    Accès plus rapide à de nouvelles technologies.

    Scalabilité

    Capacité à absorber la croissance.

    Expansion

    Déploiement plus rapide dans de nouveaux marchés.

    La valeur est donc multidimensionnelle.


    Comment réussir une migration cloud ?

    Une migration réussie commence rarement par :

    “Déplaçons tout.”

    Elle commence par une stratégie.


    Étape 1 : définir l’objectif business

    Pourquoi migrer ?

    Réduire les coûts ?

    Accélérer les déploiements ?

    Améliorer la disponibilité ?

    Internationaliser ?

    Moderniser ?

    Si vous ne connaissez pas l’objectif :

    vous ne pourrez pas mesurer la réussite.


    Étape 2 : inventorier

    Listez :

    • applications ;
    • bases ;
    • serveurs ;
    • données ;
    • dépendances ;
    • flux réseau.

    De nombreuses entreprises découvrent pendant cette étape qu’elles ne savent même plus exactement ce qu’elles possèdent.


    Étape 3 : classer les applications

    Pour chaque application :

    • migrer telle quelle ;
    • adapter ;
    • reconstruire ;
    • remplacer ;
    • supprimer ;
    • conserver.

    Toutes ne méritent pas le même traitement.


    Étape 4 : calculer le business case

    Comparez :

    Coût actuel

    Infrastructure + personnes + licences + locaux + maintenance.

    Coût futur

    Cloud + migration + équipe + outils + support + réseau.

    Puis ajoutez :

    la valeur opérationnelle attendue.


    Étape 5 : commencer petit

    Choisissez un workload :

    • relativement simple ;
    • peu critique ;
    • mais suffisamment représentatif.

    Migrez.

    Observez.

    Apprenez.

    Puis élargissez.

    C’est souvent beaucoup plus intelligent qu’un gigantesque “big bang”.


    Étape 6 : sécuriser dès le départ

    Ne migrez pas d’abord pour ajouter la sécurité ensuite.

    Définissez :

    • identités ;
    • permissions ;
    • chiffrement ;
    • logs ;
    • sauvegardes ;
    • segmentation réseau.

    La sécurité doit faire partie de l’architecture.


    Étape 7 : mettre en place la gouvernance

    Qui peut créer des ressources ?

    Quelles régions sont autorisées ?

    Quels types de machines ?

    Comment nommer les ressources ?

    Qui vérifie les coûts ?

    Sans gouvernance, le cloud peut devenir rapidement chaotique.


    Étape 8 : automatiser

    Infrastructure as Code.

    CI/CD.

    Monitoring.

    Policies.

    Le cloud atteint une grande partie de son potentiel lorsqu’il est automatisé.


    Étape 9 : mettre en place le FinOps

    Chaque équipe doit comprendre :

    ce qu’elle consomme.

    Et :

    ce que cela coûte.

    Quelques pratiques :

    • budgets ;
    • alertes ;
    • tags ;
    • rapports ;
    • right-sizing ;
    • arrêt des environnements inutiles.

    Étape 10 : mesurer après migration

    Comparez réellement.

    Disponibilité

    Meilleure ?

    Performance

    Meilleure ?

    Coût

    Conforme ?

    Temps de déploiement

    Réduit ?

    Productivité

    Améliorée ?

    Incidents

    Moins nombreux ?

    Sinon, vous ne saurez jamais si la migration a réellement créé de la valeur.


    Les principaux KPI d’une migration cloud

    Coût par utilisateur

    Très utile pour les plateformes SaaS.

    Coût cloud / chiffre d’affaires

    Mesure l’évolution économique.

    Utilisation des ressources

    CPU.

    RAM.

    Stockage.

    Temps de déploiement

    Avant / après.

    Fréquence de déploiement

    Combien de mises en production ?

    Disponibilité

    Pourcentage de disponibilité.

    MTTR

    Temps moyen nécessaire pour restaurer un service après incident.

    Coût des ressources inutilisées

    Permet de suivre le gaspillage.

    Temps nécessaire pour créer un environnement

    Indicateur très concret d’agilité.


    Les 10 erreurs classiques d’une migration cloud

    Erreur n°1 : migrer sans objectif

    Vous obtenez :

    la même entreprise,

    avec une nouvelle facture.


    Erreur n°2 : tout faire en lift and shift

    Rapide.

    Mais parfois très coûteux à long terme.


    Erreur n°3 : considérer le cloud comme un datacenter distant

    Vous passez à côté d’une grande partie de sa valeur.


    Erreur n°4 : sous-estimer les coûts réseau

    Particulièrement pour les gros volumes de données.


    Erreur n°5 : donner trop de droits

    La gestion des identités est critique.


    Erreur n°6 : oublier le FinOps

    La facture grossit progressivement.

    Personne ne sait pourquoi.


    Erreur n°7 : adopter trop de services

    Votre équipe maîtrise :

    3 technologies.

    Puis votre architecture en utilise :

    Complexité énorme.


    Erreur n°8 : migrer les applications inutiles

    Supprimer est parfois la meilleure migration.


    Erreur n°9 : ne pas former l’équipe

    Un nouvel environnement demande :

    de nouvelles compétences.


    Erreur n°10 : croire que le fournisseur gère tout

    Le cloud reste un modèle de responsabilités partagées.


    Cloud et startups : pourquoi le modèle est particulièrement puissant

    Imaginez une startup qui lance son MVP.

    Elle ignore si elle aura :

    10 utilisateurs

    ou :

    10 millions.

    Acheter dès le premier jour une infrastructure pour 10 millions serait absurde.

    Le cloud lui permet de :

    commencer petit.

    Tester.

    Obtenir des clients.

    Puis investir progressivement.

    Cela change fondamentalement l’économie de création d’une entreprise technologique.


    Et pour une PME ?

    Le besoin est différent.

    Une PME peut utiliser le cloud principalement pour :

    • logiciels SaaS ;
    • sauvegardes ;
    • collaboration ;
    • CRM ;
    • ERP ;
    • cybersécurité ;
    • hébergement web.

    Elle n’a pas besoin de devenir experte Kubernetes pour bénéficier du cloud.

    C’est essentiel à comprendre.

    Adopter le cloud ne signifie pas devenir une entreprise cloud-native du jour au lendemain.


    Et pour une grande entreprise ?

    Les enjeux deviennent :

    • milliers d’applications ;
    • réglementation ;
    • coûts ;
    • héritage technique ;
    • sécurité ;
    • gouvernance ;
    • multicloud ;
    • hybride.

    La migration devient alors un programme stratégique de plusieurs années.

    Ce n’est plus simplement un projet informatique.


    Cloud-native : qu’est-ce que cela signifie ?

    Une application :

    hébergée dans le cloud

    n’est pas nécessairement :

    cloud-native.

    Une application cloud-native est généralement conçue pour exploiter davantage :

    • automatisation ;
    • élasticité ;
    • services distribués ;
    • conteneurs ;
    • infrastructure programmable.

    Exemple :

    Vous prenez un logiciel de 2005.

    Vous le placez sur une machine virtuelle AWS.

    Il est :

    dans le cloud.

    Mais pas nécessairement :

    cloud-native.


    Serverless : encore une étape d’abstraction

    Avec le serverless, les développeurs se préoccupent encore moins directement des serveurs.

    Ils déploient :

    • fonctions ;
    • applications ;
    • logique métier.

    Le fournisseur gère :

    • capacité ;
    • infrastructure ;
    • certains mécanismes de scaling.

    Contrairement à ce que le nom suggère :

    il existe toujours des serveurs.

    Simplement :

    vous ne les administrez plus directement.


    Cloud, Kubernetes et serverless : comment tout cela s’articule ?

    Imaginez plusieurs niveaux.

    Machine virtuelle

    Vous gérez beaucoup.

    Conteneurs

    Plus standardisés.

    Kubernetes

    Vous orchestrez de nombreux workloads.

    PaaS

    Le fournisseur gère davantage d’infrastructure.

    Serverless

    L’infrastructure devient encore plus abstraite.

    Il n’existe pas de niveau universellement meilleur.

    Tout dépend du besoin.


    Une entreprise doit-elle forcément devenir cloud-native ?

    Non.

    C’est exactement la même erreur que :

    “Tout le monde doit utiliser Kubernetes.”

    Une entreprise devrait devenir cloud-native uniquement si les bénéfices :

    • rapidité ;
    • scalabilité ;
    • automatisation ;
    • résilience ;

    justifient réellement :

    • transformation ;
    • coût ;
    • complexité.

    Le futur sera-t-il 100 % cloud ?

    Probablement pas de manière universelle.

    Nous allons plutôt vers un monde combinant :

    • cloud public ;
    • cloud privé ;
    • edge computing ;
    • SaaS ;
    • infrastructure locale ;
    • infrastructures spécialisées.

    Les entreprises chercheront surtout à placer chaque workload :

    au bon endroit.

    C’est d’ailleurs la logique du cloud hybride.


    Ce qui change réellement avec le cloud

    Le changement le plus profond n’est peut-être pas technologique.

    Avant, l’infrastructure était principalement :

    un actif physique.

    Avec le cloud, elle devient davantage :

    un service programmable.

    Cela change :

    • la vitesse ;
    • les responsabilités ;
    • les coûts ;
    • les compétences.

    Et surtout :

    cela rapproche l’infrastructure du rythme du produit.


    La question stratégique : le cloud est-il un coût ou un levier ?

    Imaginez deux entreprises.

    Entreprise A

    Objectif cloud :

    réduire la facture de 15 %.

    Entreprise B

    Objectif cloud :

    réduire de six semaines à deux jours le lancement d’un nouveau marché.

    La première pense principalement :

    infrastructure.

    La deuxième pense :

    business.

    Les économies peuvent être importantes.

    Mais les plus grands bénéfices du cloud peuvent parfois venir de :

    • vitesse ;
    • innovation ;
    • scalabilité ;
    • résilience.

    Pas simplement du prix d’un serveur.


    Checklist : votre entreprise est-elle prête pour une migration cloud ?

    Objectifs

    • Nous savons pourquoi nous voulons migrer.
    • Nous avons des objectifs mesurables.
    • Nous avons identifié la valeur business attendue.

    Technique

    • Nos applications sont inventoriées.
    • Les dépendances sont connues.
    • Les besoins de performance sont mesurés.
    • Les contraintes réseau sont identifiées.

    Finance

    • Nous connaissons notre coût actuel.
    • Nous avons estimé le TCO cloud.
    • Nous avons intégré le coût de migration.
    • Nous avons intégré les coûts de réseau et de support.
    • Une gouvernance FinOps est prévue.

    Sécurité

    • Les règles d’accès sont définies.
    • Les données sensibles sont identifiées.
    • Le chiffrement est prévu.
    • Les sauvegardes sont définies.
    • Les obligations réglementaires sont connues.

    Organisation

    • Les équipes sont formées.
    • Les responsabilités sont claires.
    • Nous savons qui exploitera la plateforme.
    • Nous avons défini les procédures d’incident.

    Migration

    • Nous avons identifié un premier workload pilote.
    • Nous avons un plan de rollback.
    • Nous avons défini des KPI avant la migration.

    Si une majorité de ces questions restent sans réponse, votre priorité n’est probablement pas encore :

    migrer.

    Elle est :

    préparer la migration.


    Plan simple de migration en 90 jours

    Pour un périmètre limité, une approche pourrait ressembler à ceci.

    Jours 1 à 30 — Comprendre

    • inventorier ;
    • analyser les coûts ;
    • identifier les dépendances ;
    • définir les objectifs ;
    • choisir un workload pilote.

    Jours 31 à 60 — Construire

    • créer l’environnement cloud ;
    • mettre en place la sécurité ;
    • automatiser ;
    • migrer les données ;
    • tester.

    Jours 61 à 90 — Valider

    • migrer progressivement ;
    • mesurer ;
    • optimiser ;
    • documenter ;
    • décider de la prochaine application.

    L’objectif n’est pas de déplacer toute l’entreprise en trois mois.

    L’objectif est :

    d’apprendre suffisamment pour industrialiser la suite.


    Les questions que tout dirigeant devrait poser à son équipe avant une migration

    Même si vous n’êtes pas technicien, vous pouvez poser :

    Pourquoi migrons-nous ?

    Quel problème business cela résout-il ?

    Combien coûte l’infrastructure actuelle ?

    Quel sera le coût total après migration ?

    Quelle partie peut être supprimée plutôt que migrée ?

    Quelles applications resteront sur site ?

    Quel risque crée notre dépendance au fournisseur ?

    Comment récupérerons-nous nos données si nous voulons partir ?

    Qui contrôlera les dépenses ?

    Comment mesurerons-nous le succès ?

    Ces questions sont parfois plus importantes que :

    “AWS ou Azure ?”


    Conclusion : les entreprises ne migrent pas vers le cloud simplement parce que le cloud est moderne

    Elles migrent parce que leur environnement économique demande de plus en plus :

    de la vitesse.

    de la flexibilité.

    de la capacité à évoluer.

    de la disponibilité.

    de l’automatisation.

    Le cloud permet de transformer l’infrastructure informatique d’un investissement relativement rigide vers un ensemble de ressources disponibles à la demande.

    Mais ce modèle apporte également de nouveaux défis.

    Les données 2026 de Flexera illustrent notamment l’importance prise par la maîtrise des coûts : 85 % des répondants de son enquête citent ce sujet comme leur principal défi cloud et l’estimation moyenne du gaspillage des dépenses IaaS/PaaS atteint 29 %.

    Autrement dit :

    le cloud facilite énormément la consommation d’informatique.

    Il ne garantit absolument pas :

    une consommation intelligente de l’informatique.

    Une bonne stratégie cloud ne consiste donc pas à :

    “Tout migrer le plus vite possible.”

    Elle consiste à déterminer :

    ce qui doit migrer.

    pourquoi.

    vers quel modèle.

    avec quel niveau de service.

    avec quel coût.

    Et surtout :

    pour quel résultat business.

    Car une entreprise peut parfaitement réussir sa migration technique…

    et rater complètement sa transformation économique.

    Elle peut avoir :

    des architectures magnifiques,

    des dashboards impressionnants,

    des centaines de services cloud,

    et pourtant :

    aucun gain de productivité,

    aucune baisse de coûts,

    aucune accélération commerciale.

    La véritable réussite apparaît lorsque le cloud permet à l’entreprise de :

    prendre de meilleures décisions, lancer plus vite, absorber la croissance et consacrer davantage de ressources à ce qui crée réellement de la valeur pour ses clients.

    La meilleure infrastructure n’est pas celle qui est “dans le cloud”. C’est celle qui soutient efficacement le modèle économique de l’entreprise.


    Votre entreprise envisage une migration vers le cloud ?

    Avant de choisir une technologie ou un fournisseur, il faut d’abord comprendre ce que la migration doit réellement apporter à l’activité.

    Chez Tommy Montégu Conseil, nous accompagnons les entrepreneurs, startups et dirigeants dans leurs choix de développement, de structuration et de rentabilité.

    Dans un projet technologique, cela signifie notamment prendre du recul sur :

    • le business case ;
    • les coûts ;
    • les priorités ;
    • la scalabilité ;
    • les processus ;
    • l’organisation ;
    • la rentabilité ;
    • les investissements ;
    • les risques liés à la croissance.

    Car migrer une infrastructure simplement parce que “tout le monde va dans le cloud” n’est pas une stratégie.

    La bonne question est :

    “Est-ce que cette décision rend réellement notre entreprise plus rapide, plus robuste ou plus rentable ?”

    Si la réponse est clairement oui, le cloud peut devenir un formidable accélérateur.

    Dans le cas contraire, la meilleure décision peut parfois être…

    de ne pas migrer tout de suite.

  • Kubernetes expliqué simplement : comprendre à quoi ça sert, comment ça fonctionne et quand l’utiliser.

    Kubernetes expliqué simplement : comprendre à quoi ça sert, comment ça fonctionne et quand l’utiliser.


    Kubernetes.

    Le mot apparaît dans presque toutes les conversations autour du cloud, du DevOps et des infrastructures modernes.

    Les développeurs en parlent.

    Les ingénieurs DevOps en parlent.

    Les fournisseurs cloud en parlent.

    Les offres d’emploi le mentionnent.

    Et lorsque l’on cherche une explication en ligne, on tombe souvent sur des expressions comme :

    “orchestration de workloads conteneurisés”

    “architecture distribuée”

    “control plane”

    “autoscaling horizontal”

    “gestion déclarative de l’état”

    Techniquement, tout cela est correct.

    Mais si vous découvrez Kubernetes, cela ne vous aide probablement pas beaucoup.

    Alors commençons autrement.

    Imaginez que vous possédez un restaurant.

    Vous n’avez qu’un seul cuisinier.

    Tout fonctionne correctement lorsqu’il y a 20 clients.

    Puis 200 personnes arrivent.

    Vous devez rapidement :

    • ajouter des cuisiniers ;
    • répartir les commandes ;
    • vérifier que personne ne manque d’ingrédients ;
    • remplacer immédiatement un cuisinier absent ;
    • rediriger les commandes si un poste de travail tombe en panne ;
    • réduire l’équipe lorsque le restaurant se vide.

    Maintenant imaginez un système capable de gérer automatiquement une grande partie de cette organisation.

    Pour les applications informatiques, Kubernetes joue en partie ce rôle.

    La définition officielle est la suivante : Kubernetes est une plateforme open source destinée à gérer des applications conteneurisées en automatisant notamment leur déploiement, leur montée en charge et leur exploitation. Le projet a été ouvert par Google en 2014 et est aujourd’hui hébergé par la Cloud Native Computing Foundation.

    En version simple :

    Kubernetes est un système qui aide à faire fonctionner automatiquement de nombreux conteneurs informatiques, même lorsque les applications grossissent, tombent en panne ou doivent être mises à jour.

    Et pour comprendre pourquoi cela peut être extrêmement utile, il faut d’abord revenir aux conteneurs.


    Avant Kubernetes : comprendre les conteneurs

    Imaginez que votre entreprise développe une application.

    Pour fonctionner, cette application a besoin de plusieurs choses :

    • son code ;
    • une certaine version de Python ou Node.js ;
    • différentes bibliothèques ;
    • certaines configurations ;
    • différents composants système.

    Le problème est classique.

    Un développeur dit :

    “Chez moi, ça fonctionne.”

    Puis l’application est installée sur un serveur.

    Et là :

    “Ça ne fonctionne plus.”

    Pourquoi ?

    Parce que l’environnement est différent.

    Les versions ne sont pas les mêmes.

    Des dépendances manquent.

    Une configuration change.

    Les conteneurs ont notamment été popularisés pour réduire ce genre de problème.


    Qu’est-ce qu’un conteneur ?

    Un conteneur permet d’emballer une application avec une grande partie de ce dont elle a besoin pour fonctionner.

    Imaginez une boîte.

    À l’intérieur :

    • l’application ;
    • ses bibliothèques ;
    • ses dépendances ;
    • sa configuration d’exécution.

    Cette boîte peut ensuite être exécutée dans différents environnements de manière beaucoup plus cohérente.

    C’est notamment ce que permettent les technologies de conteneurisation comme Docker.

    Une analogie intéressante est celle du transport maritime.

    Avant la standardisation des conteneurs de fret, transporter des marchandises très différentes était compliqué.

    Puis nous avons créé une boîte standard.

    Peu importe ce qu’elle contient :

    • vêtements ;
    • matériel ;
    • nourriture.

    Le port sait comment déplacer la boîte.

    Le bateau sait comment transporter la boîte.

    Le camion sait comment transporter la boîte.

    Dans l’informatique moderne, le conteneur joue un rôle comparable.


    Mais alors, si Docker existe, pourquoi avons-nous besoin de Kubernetes ?

    Parce qu’utiliser quelques conteneurs est relativement simple.

    En gérer des centaines ou des milliers l’est beaucoup moins.

    Imaginez une application composée de :

    • 20 conteneurs pour le frontend ;
    • 30 conteneurs pour l’API ;
    • 10 services internes ;
    • plusieurs workers ;
    • différents environnements.

    Maintenant ajoutez :

    • plusieurs serveurs ;
    • plusieurs régions ;
    • des pics de trafic ;
    • des déploiements quotidiens ;
    • des pannes.

    Très vite, de nouvelles questions apparaissent.

    Quel conteneur doit fonctionner sur quel serveur ?

    Que faire lorsqu’un conteneur tombe en panne ?

    Comment en démarrer davantage lorsque le trafic augmente ?

    Comment envoyer les utilisateurs vers les bons conteneurs ?

    Comment remplacer progressivement une ancienne version de l’application par une nouvelle ?

    Comment utiliser efficacement les ressources disponibles ?

    C’est précisément ici que Kubernetes devient intéressant.

    La documentation officielle explique notamment que Kubernetes sait gérer le scaling, le failover, les déploiements progressifs, le load balancing, la découverte de services et le redémarrage de conteneurs défaillants.


    Kubernetes est donc un orchestrateur

    Le mot utilisé est :

    orchestration de conteneurs.

    Imaginez un chef d’orchestre.

    Il ne joue pas directement :

    • du violon ;
    • du piano ;
    • de la trompette ;
    • de la batterie.

    Il coordonne l’ensemble.

    Kubernetes fait quelque chose de comparable avec les conteneurs.

    Vous lui dites essentiellement :

    “Je veux que mon application fonctionne comme ceci.”

    Puis Kubernetes travaille en permanence pour maintenir cette situation.


    Le concept le plus important de Kubernetes : l’état désiré

    C’est probablement LE concept à comprendre.

    Kubernetes fonctionne beaucoup autour d’une logique déclarative.

    Vous ne lui dites pas nécessairement :

    “Démarre ce conteneur sur le serveur numéro 3.”

    Vous dites plutôt :

    “Je veux que trois exemplaires de cette application fonctionnent en permanence.”

    Kubernetes regarde alors la réalité.

    Il trouve :

    3 exemplaires.

    Tout va bien.

    Puis l’un tombe en panne.

    Situation actuelle :

    Situation désirée :

    Kubernetes essaie donc d’en recréer un.

    La documentation officielle décrit cette logique comme le rapprochement permanent entre l’état actuel du cluster et l’état souhaité déclaré par l’utilisateur.

    C’est une différence fondamentale.


    Exemple extrêmement simple

    Vous possédez une application appelée :

    TommyApp

    Vous dites à Kubernetes :

    “Je veux toujours cinq instances de TommyApp.”

    Kubernetes en lance cinq.

    Une tombe en panne.

    Il en reste quatre.

    Kubernetes constate :

    désiré : 5
    réel : 4

    Il crée donc une nouvelle instance.

    Quelques secondes plus tard :

    désiré : 5
    réel : 5

    Voilà une grande partie de la philosophie Kubernetes.


    Qu’est-ce qu’un cluster Kubernetes ?

    Kubernetes fonctionne à l’intérieur de ce que l’on appelle un :

    cluster.

    Un cluster est simplement un ensemble de machines travaillant ensemble.

    Ces machines peuvent être :

    • physiques ;
    • virtuelles ;
    • hébergées dans le cloud.

    La documentation officielle distingue deux grandes parties dans un cluster :

    le control plane

    et :

    les worker nodes.

    Voyons cela simplement.


    Le Control Plane : le cerveau

    Le Control Plane prend les grandes décisions concernant le cluster.

    Il sait notamment :

    • ce que vous voulez exécuter ;
    • ce qui fonctionne actuellement ;
    • quelles machines sont disponibles ;
    • où envoyer les workloads.

    Imaginez :

    la tour de contrôle d’un aéroport.

    Elle ne transporte aucun passager.

    Mais elle coordonne le fonctionnement global.


    Les Nodes : les machines qui travaillent

    Les nodes sont les machines sur lesquelles les applications sont réellement exécutées.

    On les appelle souvent :

    worker nodes.

    Imaginez un entrepôt.

    Le Control Plane est le responsable logistique.

    Les nodes sont les zones dans lesquelles le travail est réalisé.

    Un cluster peut avoir :

    • 1 node ;
    • 3 nodes ;
    • 50 nodes ;
    • des centaines de nodes.

    Cela dépend de l’infrastructure.


    Et Kubernetes décide où placer les applications

    Imaginons trois machines.

    Node A

    CPU disponible : faible.

    Node B

    CPU disponible : élevé.

    Node C

    CPU disponible : moyen.

    Une nouvelle application doit être lancée.

    Kubernetes peut examiner les contraintes et ressources disponibles afin de déterminer où placer le nouveau workload.

    Le composant chargé notamment de cette décision s’appelle :

    kube-scheduler.

    Vous n’avez donc pas nécessairement besoin de gérer manuellement chaque placement.


    Maintenant, parlons du mot que vous verrez absolument partout : Pod

    Si vous lisez seulement une notion Kubernetes aujourd’hui, retenez celle-ci.

    Le plus petit objet informatique déployable dans Kubernetes est appelé :

    Pod.

    La documentation officielle définit le Pod comme la plus petite unité de calcul déployable que Kubernetes peut créer et gérer.

    Dans la majorité des cas, un Pod contient un conteneur principal.

    Il peut néanmoins en contenir plusieurs lorsqu’ils doivent fonctionner très étroitement ensemble.


    Pourquoi Kubernetes ne gère-t-il pas directement simplement “des conteneurs” ?

    Parce qu’il introduit une couche supplémentaire.

    Imaginez :

    conteneur → application emballée

    Pod → environnement d’exécution Kubernetes contenant un ou plusieurs conteneurs

    Cela permet notamment aux conteneurs présents dans un même Pod de partager certaines ressources réseau et de stockage.

    Mais pour débuter, retenez simplement :

    Pod ≈ l’unité dans laquelle Kubernetes fait fonctionner votre application.


    Exemple

    Votre application web fonctionne dans un conteneur.

    Kubernetes démarre ce conteneur dans :

    Pod 1

    Puis vous voulez trois exemplaires.

    Vous obtenez :

    Pod 1

    Pod 2

    Pod 3

    Les trois exécutent la même application.


    Mais on ne crée généralement pas directement les Pods

    Voilà une autre notion importante.

    Les Pods sont relativement éphémères.

    Ils peuvent :

    • disparaître ;
    • être recréés ;
    • changer d’adresse IP.

    La documentation Kubernetes souligne explicitement qu’un Pod individuel ne doit pas être considéré comme une ressource durable.

    On utilise donc généralement des objets qui les gèrent.

    Le plus connu est :

    Deployment.


    Qu’est-ce qu’un Deployment ?

    Un Deployment indique à Kubernetes comment une application doit être déployée et maintenue.

    Par exemple :

    Application : TommyApp
    Version : 2.1
    Réplicas : 5

    Kubernetes essaiera de maintenir cinq Pods exécutant cette version.

    La documentation officielle précise qu’un Deployment fournit des mises à jour déclaratives pour les Pods et les ReplicaSets.

    En langage simple :

    Le Deployment est le responsable qui veille à ce que la bonne version de votre application fonctionne avec le bon nombre d’exemplaires.


    Pourquoi lancer plusieurs exemplaires de la même application ?

    Pour plusieurs raisons.

    Disponibilité

    Si l’un tombe en panne, les autres continuent.

    Performance

    Les utilisateurs peuvent être répartis entre plusieurs instances.

    Scalabilité

    Vous pouvez augmenter le nombre d’instances lorsque la demande augmente.

    Par exemple :

    Trafic normal :

    3 Pods.

    Black Friday :

    20 Pods.

    Puis après le pic :

    5 Pods.


    Kubernetes peut-il faire cela automatiquement ?

    Oui.

    Kubernetes possède notamment un mécanisme appelé :

    Horizontal Pod Autoscaler, ou HPA.

    Il peut ajuster automatiquement le nombre de Pods d’un workload selon certaines métriques, par exemple l’utilisation CPU, la mémoire ou des métriques personnalisées.

    Imaginez :

    CPU moyen > 70 %.

    Kubernetes augmente progressivement :

    5 Pods → 8 → 12.

    Le trafic redescend.

    Kubernetes peut ensuite réduire :

    12 → 8 → 5.

    C’est ce qu’on appelle du horizontal scaling.


    Horizontal scaling et vertical scaling

    Deux notions à distinguer.

    Scaling vertical

    Vous rendez une machine plus puissante.

    Exemple :

    4 Go RAM → 16 Go RAM.

    C’est comme remplacer un employé par un super-employé.


    Scaling horizontal

    Vous ajoutez davantage d’instances.

    Exemple :

    3 Pods → 15 Pods.

    C’est comme ajouter des employés supplémentaires.

    Kubernetes est particulièrement adapté au deuxième modèle.


    Mais comment les utilisateurs savent-ils vers quel Pod aller ?

    Très bonne question.

    Les Pods peuvent être créés et détruits régulièrement.

    Leur identité réseau peut donc changer.

    Vous ne voulez évidemment pas que votre application mobile doive connaître :

    Pod 1 : 10.0.2.53
    Pod 2 : 10.0.8.17
    Pod 3 : 10.0.7.29

    Et devoir mettre à jour cette liste en permanence.

    Kubernetes possède pour cela un objet appelé :

    Service.


    Qu’est-ce qu’un Service Kubernetes ?

    Un Service fournit un point d’accès stable devant plusieurs Pods.

    La documentation officielle définit le Service comme un moyen d’exposer une application réseau composée d’un ou plusieurs Pods derrière un endpoint cohérent.

    Imaginez un restaurant.

    Vous appelez :

    01 23 45 67 89

    Vous ne savez pas quel employé répondra.

    Et peu importe.

    Le numéro reste le même.

    Le Service fonctionne un peu de cette manière.


    Exemple

    Votre Service s’appelle :

    api-tommy

    Derrière :

    Pod A
    Pod B
    Pod C

    Une requête arrive.

    Le Service permet de l’envoyer vers l’un des Pods disponibles.

    Si Pod B disparaît :

    Pod A
    Pod C

    Le Service continue de fonctionner.

    Puis Kubernetes recrée :

    Pod D

    Le système peut reprendre normalement.


    Et pour recevoir du trafic venant d’Internet ?

    C’est là que l’on rencontre d’autres mécanismes de networking Kubernetes.

    Selon l’architecture, on peut utiliser :

    • un Service de type LoadBalancer ;
    • Ingress ;
    • ou désormais différents mécanismes basés sur la Gateway API.

    Pour un débutant, retenez simplement :

    Kubernetes possède plusieurs couches permettant de diriger le trafic extérieur vers les bonnes applications à l’intérieur du cluster.

    Il n’est pas nécessaire d’en comprendre tous les détails pour saisir le principe général.


    Kubernetes est capable de s’auto-réparer

    C’est l’un de ses avantages les plus connus.

    Imaginez :

    10 instances de votre application fonctionnent.

    Deux plantent.

    Kubernetes détecte la situation et peut les remplacer.

    Il peut également redémarrer certains conteneurs défaillants et éviter d’envoyer du trafic vers des instances qui ne sont pas encore considérées comme prêtes.

    C’est ce que l’on appelle souvent :

    self-healing.

    Attention toutefois.

    Cela ne signifie pas que Kubernetes peut réparer :

    • un bug dans votre code ;
    • une mauvaise architecture ;
    • une base de données corrompue.

    Il peut remplacer un composant qui ne fonctionne plus.

    Il ne transforme pas automatiquement un mauvais logiciel en bon logiciel.


    Comment Kubernetes sait-il qu’une application fonctionne ?

    Il existe notamment des mécanismes appelés :

    probes.

    Par exemple :

    Readiness Probe

    Question :

    “Cette application est-elle prête à recevoir du trafic ?”


    Liveness Probe

    Question :

    “Cette application fonctionne-t-elle toujours correctement ?”


    Startup Probe

    Question :

    “L’application a-t-elle terminé son démarrage ?”

    Ces vérifications permettent à Kubernetes de prendre de meilleures décisions.


    Exemple concret

    Votre API démarre normalement en 20 secondes.

    Pendant ces 20 secondes, elle ne doit pas recevoir de trafic.

    Une readiness probe peut permettre à Kubernetes de savoir :

    “Pas encore prête.”

    Puis :

    “Prête.”

    Le trafic peut alors commencer.


    Kubernetes facilite également les mises à jour

    Imaginez que votre application fonctionne avec :

    10 Pods version 1.

    Vous souhaitez déployer :

    version 2.

    Sans orchestration correcte, vous pourriez :

    1. arrêter les 10 anciennes instances ;
    2. déployer les nouvelles ;
    3. espérer que tout fonctionne.

    Résultat possible :

    plusieurs minutes d’indisponibilité.

    Kubernetes peut effectuer un rolling update.

    Par exemple :

    10 version 1

    puis :

    8 version 1 + 2 version 2

    puis :

    6 + 4

    puis :

    4 + 6

    puis :

    2 + 8

    puis :

    10 version 2.

    Les Deployments sont justement conçus pour permettre ce type de mise à jour progressive.


    Et si la nouvelle version fonctionne mal ?

    Selon la manière dont votre déploiement et votre pipeline sont configurés, vous pouvez revenir vers une version antérieure.

    C’est ce qu’on appelle :

    rollback.

    Kubernetes fournit les briques permettant de réaliser ces changements de manière contrôlée.


    ConfigMap : séparer le code de la configuration

    Imaginez votre application.

    Elle possède différentes configurations.

    En développement

    API_URL = localhost

    En production

    API_URL = api.monsite.com

    Vous ne voulez pas nécessairement créer une nouvelle image de conteneur pour chaque petit changement de configuration.

    Kubernetes propose notamment les :

    ConfigMaps.

    Ils permettent de stocker certaines configurations séparément de l’image applicative.


    Et les mots de passe ?

    On évite évidemment d’écrire directement :

    PASSWORD = “supermotdepasse123”

    dans le code.

    Kubernetes possède un objet :

    Secret.

    Il permet de gérer certaines informations sensibles comme :

    • mots de passe ;
    • tokens ;
    • clés.

    La documentation officielle inclut explicitement la gestion de configuration et de secrets parmi les fonctions fournies par Kubernetes.

    Attention toutefois :

    utiliser un Secret Kubernetes ne garantit pas à lui seul une sécurité parfaite.

    La gestion des secrets nécessite une stratégie globale :

    • chiffrement ;
    • droits d’accès ;
    • rotation ;
    • gestion des identités ;
    • éventuellement coffre-fort externe.

    Et les données persistantes ?

    Un Pod peut disparaître.

    Mais vous ne voulez évidemment pas perdre :

    • fichiers ;
    • données ;
    • contenus utilisateurs ;

    chaque fois qu’il est recréé.

    Kubernetes possède donc plusieurs mécanismes permettant de gérer le stockage.

    Parmi eux :

    PersistentVolume

    et :

    PersistentVolumeClaim.

    La documentation officielle indique que Kubernetes sait orchestrer le montage de différents systèmes de stockage, qu’ils soient locaux ou proposés par des fournisseurs cloud.


    Une analogie simple pour retenir les principaux objets Kubernetes

    Imaginez une chaîne de restaurants.

    Cluster

    L’ensemble du réseau.

    Node

    Un restaurant.

    Pod

    Un poste de cuisine.

    Container

    Le cuisinier et son équipement de travail.

    Deployment

    La règle :

    “Je veux toujours quatre postes capables de préparer ce plat.”

    Service

    Le comptoir où arrivent les commandes.

    ConfigMap

    Le manuel de fonctionnement.

    Secret

    Les informations confidentielles.

    Autoscaler

    Le responsable qui ajoute du personnel lorsqu’il y a beaucoup de clients.

    Ce n’est évidemment pas techniquement parfait.

    Mais cela permet de retenir les rôles.


    Que fait Kubernetes lorsqu’un serveur entier tombe en panne ?

    Supposons un cluster avec :

    Node A
    Node B
    Node C.

    Des Pods fonctionnent sur chaque machine.

    Node B tombe en panne.

    Kubernetes peut constater que certaines applications ne disposent plus du nombre d’instances désiré.

    Il peut alors essayer de recréer les workloads sur les nodes restants si ceux-ci possèdent suffisamment de ressources.

    C’est l’une des raisons pour lesquelles Kubernetes est intéressant pour construire des systèmes plus résilients.


    Mais attention : Kubernetes ne rend pas automatiquement votre application “haute disponibilité”

    C’est une idée reçue.

    Vous pouvez déployer une application mal conçue sur Kubernetes.

    Elle restera mal conçue.

    Par exemple :

    vous possédez une base de données unique.

    Elle tombe.

    Votre application s’arrête.

    Même si vos 40 Pods web fonctionnent parfaitement.

    La haute disponibilité concerne l’architecture complète :

    • application ;
    • base de données ;
    • réseau ;
    • stockage ;
    • DNS ;
    • fournisseurs externes ;
    • zones géographiques.

    Kubernetes est une brique.

    Pas une baguette magique.


    Kubernetes fonctionne-t-il uniquement dans le cloud ?

    Non.

    C’est justement l’un de ses avantages.

    Kubernetes peut être utilisé :

    • sur un cloud public ;
    • dans un datacenter privé ;
    • sur des machines physiques ;
    • dans certains environnements hybrides.

    La documentation officielle met en avant sa portabilité entre différents clouds et distributions.

    On peut notamment trouver des services Kubernetes managés chez les grands fournisseurs cloud.


    Kubernetes managé : souvent plus réaliste pour une entreprise

    Installer Kubernetes soi-même est possible.

    Mais gérer correctement un cluster de production signifie également gérer :

    • control plane ;
    • upgrades ;
    • sécurité ;
    • réseau ;
    • stockage ;
    • sauvegardes ;
    • monitoring.

    Beaucoup d’entreprises choisissent donc des services Kubernetes managés.

    Le fournisseur prend en charge une partie de l’infrastructure.

    Cela ne supprime pas toute la complexité.

    Mais cela évite d’avoir à tout administrer soi-même.


    Kubernetes et Docker : concurrents ?

    Non.

    C’est une confusion fréquente.

    Docker et Kubernetes ne répondent pas exactement au même problème.

    Docker a largement popularisé la création et l’exécution de conteneurs.

    Kubernetes orchestre des workloads conteneurisés à grande échelle.

    En simplifiant :

    Docker aide à emballer et exécuter votre application dans un conteneur.

    Kubernetes aide à organiser beaucoup de conteneurs dans une infrastructure distribuée.

    Ils sont donc conceptuellement complémentaires, même si Kubernetes utilise aujourd’hui des runtimes conformes au standard CRI et n’est pas dépendant du moteur Docker historique.


    Que signifie K8s ?

    Vous verrez très souvent :

    K8s.

    Ce n’est pas une autre technologie.

    C’est simplement l’abréviation de Kubernetes.

    Pourquoi 8 ?

    K ubernetes s

    Entre le K et le s, il y a huit lettres.

    Donc :

    K + 8 + s = K8s.

    La documentation officielle confirme cette origine.


    Pourquoi Kubernetes est devenu aussi populaire ?

    Parce qu’il répond à plusieurs problèmes fondamentaux des architectures modernes.


    1. Les applications modernes sont de plus en plus distribuées

    Au lieu d’une seule application gigantesque, certaines entreprises utilisent plusieurs services.

    Par exemple :

    • service utilisateurs ;
    • service paiement ;
    • service commandes ;
    • service e-mail ;
    • service facturation.

    Kubernetes facilite le déploiement et la coordination de ce type d’environnement.


    2. Les entreprises déploient plus fréquemment

    Les équipes modernes peuvent déployer :

    • toutes les semaines ;
    • tous les jours ;
    • parfois plusieurs fois par jour.

    Kubernetes fournit des mécanismes permettant d’automatiser une partie des rollouts et rollbacks.


    3. Les besoins en capacité changent rapidement

    Un site peut recevoir :

    10 000 visiteurs lundi.

    Puis :

    500 000 mardi après une campagne.

    Une infrastructure statique peut être :

    trop petite pendant les pics,

    et :

    trop chère pendant les périodes calmes.

    L’autoscaling peut permettre une meilleure adaptation.


    4. La disponibilité est devenue critique

    Pour certains services :

    une panne de dix minutes peut coûter très cher.

    Kubernetes peut aider à créer une infrastructure capable de remplacer automatiquement certains composants défaillants.


    5. Les entreprises veulent davantage de portabilité

    Une application fortement dépendante d’une seule infrastructure peut être difficile à déplacer.

    La standardisation autour des conteneurs et de Kubernetes peut réduire certaines dépendances.

    Mais attention :

    Kubernetes ne supprime pas automatiquement le vendor lock-in.

    Si votre architecture dépend fortement :

    • d’une base propriétaire ;
    • d’un service cloud spécifique ;
    • d’une solution réseau particulière ;

    la migration restera potentiellement difficile.


    Kubernetes et les microservices

    Kubernetes est souvent associé aux :

    microservices.

    Dans une architecture monolithique, une grande partie de l’application est regroupée.

    Dans une architecture microservices, différentes fonctionnalités peuvent devenir des services indépendants.

    Exemple :

    Monolithe

    Application e-commerce unique.

    Microservices

    catalogue
    paiement
    utilisateurs
    commandes
    notifications
    livraison

    Chacun peut parfois être :

    • développé indépendamment ;
    • déployé indépendamment ;
    • scalé indépendamment.

    Kubernetes est particulièrement adapté à la gestion de ce type d’environnement.

    Mais cela ne signifie pas que toutes les entreprises doivent adopter les microservices.


    Le piège : croire que microservices + Kubernetes = architecture moderne

    Vous avez trois développeurs.

    Votre application compte 200 utilisateurs.

    Votre architecture fonctionne parfaitement.

    Puis quelqu’un dit :

    “Il faut passer en microservices Kubernetes.”

    Pourquoi ?

    “Parce que c’est plus scalable.”

    Vous pourriez alors transformer une application relativement simple en :

    • 25 services ;
    • 25 pipelines ;
    • plusieurs bases ;
    • networking complexe ;
    • monitoring distribué ;
    • Kubernetes.

    Vous venez peut-être de créer énormément de travail sans résoudre aucun problème réel.

    Une technologie moderne n’est pas nécessairement une technologie adaptée à votre entreprise.


    Quand Kubernetes devient réellement intéressant

    Kubernetes commence généralement à avoir davantage de sens lorsque plusieurs de ces conditions sont réunies.

    Votre application possède plusieurs services

    L’orchestration commence à créer de la valeur.

    Vous avez besoin d’une forte disponibilité

    La capacité de remplacement automatique devient intéressante.

    Votre trafic varie fortement

    L’autoscaling peut être utile.

    Vous effectuez beaucoup de déploiements

    Les rollouts automatisés prennent davantage de valeur.

    Plusieurs équipes travaillent sur la plateforme

    La standardisation peut simplifier l’exploitation.

    Vous avez besoin de cohérence entre plusieurs environnements

    Par exemple :

    cloud + datacenter.

    Votre infrastructure est devenue difficile à gérer manuellement

    C’est probablement le signal le plus important.


    Quand Kubernetes est probablement excessif

    Imaginez :

    • une petite entreprise ;
    • une application simple ;
    • trois développeurs ;
    • peu de trafic ;
    • une architecture monolithique ;
    • un serveur stable.

    Kubernetes peut ajouter :

    • complexité ;
    • coûts ;
    • maintenance ;
    • compétences nécessaires ;
    • temps de debug.

    Sans créer suffisamment de valeur.

    Dans ce cas, des solutions plus simples peuvent être largement suffisantes :

    • PaaS ;
    • services serverless ;
    • containers managés ;
    • machines virtuelles ;
    • Docker Compose pour certains environnements limités.

    Une règle simple

    Ne demandez pas :

    “Est-ce que Kubernetes est une bonne technologie ?”

    Oui.

    C’est une technologie extrêmement puissante.

    Demandez plutôt :

    “Les problèmes que Kubernetes résout existent-ils réellement chez nous ?”

    C’est une question beaucoup plus intelligente.


    Les avantages de Kubernetes

    Résumons.

    Automatisation

    Déploiement, remplacement de workloads, scaling.

    Résilience

    Des composants défaillants peuvent être recréés.

    Scalabilité

    Le nombre d’instances peut évoluer.

    Portabilité

    Kubernetes fonctionne dans de nombreux environnements.

    Standardisation

    Les équipes disposent d’un modèle cohérent.

    Optimisation des ressources

    Kubernetes peut répartir les workloads selon les ressources disponibles.

    Écosystème

    L’écosystème Kubernetes est aujourd’hui extrêmement important.


    Les inconvénients de Kubernetes

    Et ils existent.

    Complexité

    Kubernetes possède énormément de concepts.

    Pods.

    Deployments.

    Services.

    Ingress.

    Volumes.

    Namespaces.

    RBAC.

    Operators.

    CRD.

    Helm.

    Etc.


    Coût humain

    La technologie nécessite des compétences.

    Une mauvaise configuration Kubernetes peut être :

    • coûteuse ;
    • fragile ;
    • difficile à maintenir.

    Coût opérationnel

    Un cluster possède ses propres ressources et outils périphériques.

    Monitoring.

    Logging.

    Sécurité.

    Backups.

    Réseau.


    Debug plus difficile

    Dans un serveur traditionnel :

    “L’application ne marche plus.”

    Dans Kubernetes :

    Pod ?

    Service ?

    DNS ?

    Ingress ?

    Network Policy ?

    stockage ?

    node ?

    image ?

    configuration ?

    L’architecture distribuée crée de nouveaux problèmes.


    Kubernetes ne remplace pas le DevOps

    Autre idée reçue.

    Installer Kubernetes ne crée pas automatiquement une culture DevOps.

    Vous avez toujours besoin de :

    • CI/CD ;
    • monitoring ;
    • logs ;
    • sécurité ;
    • gestion des incidents ;
    • tests ;
    • automatisation ;
    • pratiques d’exploitation.

    Kubernetes devient simplement une partie de la plateforme.


    Que faut-il ajouter autour de Kubernetes ?

    Un environnement de production réaliste peut inclure :

    CI/CD

    Pour construire et déployer les applications.

    Registry

    Pour stocker les images de conteneurs.

    Observabilité

    Metrics, logs et traces.

    Gestion des secrets

    Pour les informations sensibles.

    Sauvegarde

    Pour les workloads et données concernés.

    Sécurité

    RBAC, policies, scanning, etc.

    DNS

    Pour résoudre les services.

    Kubernetes fournit une base importante.

    Mais pas nécessairement tout le système.

    La documentation officielle précise d’ailleurs clairement que Kubernetes n’est pas une plateforme PaaS monolithique intégrant obligatoirement toutes les briques possibles.


    Kubernetes expliqué avec un exemple complet

    Imaginons un e-commerce.

    Vous avez trois composants :

    Frontend

    Le site visible par les clients.

    API

    La logique métier.

    Worker

    Traitement des commandes en arrière-plan.

    Vous conteneurisez chaque application.


    Étape 1

    Vous créez un cluster.

    3 nodes.


    Étape 2

    Vous dites :

    frontend : 4 Pods
    API : 5 Pods
    worker : 2 Pods


    Étape 3

    Kubernetes répartit les Pods sur les machines.


    Étape 4

    Vous créez des Services.

    Le frontend peut trouver l’API.


    Étape 5

    Vous exposez le frontend à Internet.


    Étape 6

    Black Friday arrive.

    Le CPU de l’API augmente.

    Un autoscaler peut augmenter :

    5 → 15 Pods.


    Étape 7

    Un node tombe en panne.

    Certains Pods disparaissent.

    Kubernetes essaie de les recréer ailleurs.


    Étape 8

    Vous déployez API v2.

    Kubernetes remplace progressivement :

    v1 → v2.


    C’est ce type de scénario qui permet de comprendre pourquoi Kubernetes peut être extrêmement puissant.


    Quelques mots Kubernetes à connaître absolument

    Cluster

    Ensemble de machines Kubernetes.

    Node

    Machine du cluster.

    Pod

    Plus petite unité déployable.

    Container

    Application emballée avec ses dépendances.

    Deployment

    Objet qui gère notamment plusieurs Pods d’une application.

    Service

    Point réseau stable permettant d’accéder à plusieurs Pods.

    Namespace

    Moyen d’organiser logiquement certaines ressources d’un cluster.

    ConfigMap

    Configuration non sensible.

    Secret

    Informations sensibles.

    Volume

    Stockage mis à disposition des workloads.

    kubectl

    Outil en ligne de commande utilisé pour communiquer avec Kubernetes.


    Qu’est-ce que kubectl ?

    kubectl est l’outil en ligne de commande principal utilisé pour interagir avec Kubernetes. La documentation officielle le présente comme la CLI principale permettant de communiquer avec un cluster.

    Avec lui, un ingénieur peut notamment :

    • voir les Pods ;
    • déployer ;
    • consulter des logs ;
    • modifier des ressources ;
    • diagnostiquer des problèmes.

    Par exemple :

    kubectl get pods

    permet de lister les Pods visibles dans un contexte donné.


    Pourquoi parle-t-on autant de fichiers YAML ?

    Parce que Kubernetes fonctionne beaucoup avec de la configuration déclarative.

    Vous pouvez décrire une ressource dans un fichier.

    Par exemple, conceptuellement :

    Je veux une application
    nom : tommy-api
    image : tommy-api:v2
    replicas : 3

    Kubernetes lit cette déclaration.

    Puis essaie de faire correspondre la réalité à cette configuration.

    Les configurations Kubernetes sont très souvent écrites en :

    YAML.


    Le véritable changement mental apporté par Kubernetes

    Avant :

    “Quelle machine fait fonctionner mon application ?”

    Avec Kubernetes :

    “Quel état applicatif veux-je obtenir ?”

    Cette abstraction permet aux équipes de moins se concentrer sur une machine spécifique et davantage sur les propriétés attendues du système.

    C’est une différence importante.


    Kubernetes est-il réservé aux grandes entreprises ?

    Non.

    Une petite équipe peut techniquement utiliser Kubernetes.

    Mais la vraie question est économique.

    Est-ce que les bénéfices justifient :

    • la complexité ;
    • le coût ;
    • l’apprentissage ?

    Pour une startup très technique avec une architecture distribuée :

    peut-être.

    Pour un site vitrine :

    probablement pas.


    Kubernetes coûte-t-il cher ?

    Kubernetes lui-même est open source.

    Mais :

    open source ne signifie pas gratuit à exploiter.

    Vous payez potentiellement :

    • les machines ;
    • les services cloud ;
    • le stockage ;
    • le réseau ;
    • l’observabilité ;
    • les ingénieurs ;
    • la maintenance.

    La mauvaise utilisation de Kubernetes peut même augmenter fortement vos coûts cloud.

    Par exemple, si les ressources CPU et mémoire sont mal dimensionnées.


    Kubernetes peut-il réduire les coûts ?

    Oui, dans certains contextes.

    Parce qu’il peut aider à mieux utiliser les machines disponibles et à répartir les applications selon leurs besoins. La documentation officielle mentionne cette logique d’optimisation de placement, appelée notamment automatic bin packing.

    Mais encore une fois :

    cela dépend de l’architecture.

    Un cluster mal optimisé peut également coûter beaucoup plus cher qu’une solution simple.


    Kubernetes et la sécurité

    Kubernetes possède de nombreux mécanismes de sécurité.

    Par exemple :

    • contrôle d’accès ;
    • identités ;
    • secrets ;
    • politiques réseau ;
    • sécurité des workloads.

    Mais la complexité signifie également qu’une mauvaise configuration peut créer des vulnérabilités.

    Une infrastructure Kubernetes doit donc être :

    • mise à jour ;
    • configurée correctement ;
    • monitorée ;
    • auditée ;
    • sécurisée.

    Kubernetes n’est pas sécurisé simplement parce qu’il est Kubernetes.


    Faut-il apprendre Kubernetes en 2026 ?

    Pour un développeur backend, DevOps, SRE, platform engineer ou cloud engineer :

    comprendre Kubernetes reste extrêmement pertinent.

    La documentation officielle continue d’être activement maintenue et couvre actuellement les versions Kubernetes récentes, les concepts fondamentaux et de nombreuses fonctions avancées.

    Pour un dirigeant ou entrepreneur :

    vous n’avez probablement pas besoin de savoir écrire un Deployment YAML.

    Mais comprendre :

    • pourquoi l’équipe utilise Kubernetes ;
    • quel problème cela résout ;
    • quel coût cela ajoute ;
    • quel risque cela réduit ;

    peut être extrêmement utile.


    Les 7 questions à poser avant d’adopter Kubernetes

    1. Quel problème précis voulons-nous résoudre ?

    Pas :

    “Parce que tout le monde utilise Kubernetes.”


    2. Notre architecture est-elle suffisamment complexe pour le justifier ?

    Trois conteneurs ne nécessitent probablement pas le même niveau d’orchestration que 300.


    3. Possédons-nous les compétences nécessaires ?

    Sinon :

    qui maintiendra la plateforme ?


    4. Avons-nous réellement besoin de portabilité ?

    Si vous comptez rester longtemps sur un fournisseur unique, certains services managés plus simples peuvent être suffisants.


    5. Avons-nous besoin de scaling avancé ?

    Si votre trafic est stable, l’argument est moins important.


    6. Combien cela coûtera-t-il réellement ?

    Incluez :

    • infrastructure ;
    • ingénierie ;
    • monitoring ;
    • maintenance.

    7. Existe-t-il une solution plus simple ?

    C’est probablement la question la plus importante.


    Checklist : Kubernetes est-il adapté à votre entreprise ?

    Plus vous cochez de cases, plus la discussion devient intéressante.

    • Plusieurs services doivent être orchestrés.
    • L’application doit être fortement disponible.
    • Les workloads doivent pouvoir être redémarrés automatiquement.
    • Le trafic varie fortement.
    • Nous déployons fréquemment.
    • Plusieurs équipes utilisent la même infrastructure.
    • Notre infrastructure actuelle devient difficile à gérer.
    • Nous possédons des compétences DevOps / cloud.
    • Nous avons besoin d’une plateforme standardisée.
    • Nous avons évalué le coût total de possession.

    À l’inverse, si votre projet est :

    • simple ;
    • stable ;
    • peu sollicité ;
    • géré par une petite équipe ;

    Kubernetes peut être inutilement complexe.


    En résumé : Kubernetes en une minute

    Si vous ne deviez retenir que cela :

    Un conteneur contient votre application.

    Un Pod permet à Kubernetes de faire fonctionner un ou plusieurs conteneurs étroitement liés.

    Un Node est une machine qui exécute des Pods.

    Un Cluster regroupe plusieurs machines.

    Un Deployment indique combien de Pods doivent fonctionner et avec quelle version.

    Un Service permet d’accéder de manière stable à des Pods qui peuvent apparaître ou disparaître.

    Kubernetes observe en permanence l’état réel et essaie de le rapprocher de l’état que vous avez demandé.

    Et il peut notamment aider à :

    • déployer ;
    • scaler ;
    • répartir le trafic ;
    • remplacer certaines instances défaillantes ;
    • gérer les mises à jour ;
    • exploiter les ressources disponibles.

    Voilà Kubernetes.

    Pas une magie obscure.

    Pas simplement “Docker mais en plus compliqué”.

    Mais :

    un système d’orchestration conçu pour permettre à de nombreuses applications conteneurisées de fonctionner de manière plus automatisée et plus résiliente sur une infrastructure distribuée.


    Conclusion : Kubernetes est puissant précisément parce qu’il résout des problèmes complexes

    Kubernetes peut sembler intimidant.

    Et il l’est parfois.

    Mais le principe fondamental reste relativement simple.

    Vous décrivez :

    “Voilà comment je veux que mon application fonctionne.”

    Kubernetes observe ensuite :

    “Voilà comment elle fonctionne actuellement.”

    Puis essaie continuellement de réduire la différence.

    Un Pod disparaît ?

    Il peut être recréé.

    Le trafic augmente ?

    La capacité peut être augmentée.

    Une nouvelle version arrive ?

    Elle peut être déployée progressivement.

    Un serveur tombe ?

    Certains workloads peuvent être replacés.

    C’est cette automatisation qui explique l’importance prise par Kubernetes dans les infrastructures modernes.

    Mais le point le plus important pour un dirigeant n’est probablement pas technique.

    C’est celui-ci :

    Utiliser une technologie sophistiquée n’est pas un objectif. Résoudre un problème métier avec le niveau de complexité approprié l’est.

    Une infrastructure Kubernetes parfaitement conçue pour une application qui n’en a pas besoin reste une mauvaise décision.

    À l’inverse, lorsqu’une entreprise atteint un niveau de complexité où :

    • les déploiements deviennent difficiles ;
    • la disponibilité devient critique ;
    • les workloads se multiplient ;
    • les besoins évoluent constamment ;

    Kubernetes peut devenir une plateforme extrêmement puissante.

    La bonne question n’est donc pas :

    “Devons-nous utiliser Kubernetes parce que c’est moderne ?”

    Mais :

    “Notre entreprise a-t-elle atteint le niveau de complexité pour lequel Kubernetes crée davantage de valeur qu’il n’ajoute de complexité ?”

    C’est cette question qu’il faut résoudre.


    Votre infrastructure technique accompagne-t-elle réellement la croissance de votre entreprise ?

    La technologie doit permettre à une entreprise de se développer.

    Pas devenir une fin en soi.

    Une startup peut parfois complexifier son infrastructure beaucoup trop tôt.

    Une autre peut au contraire attendre trop longtemps et se retrouver freinée par une architecture devenue fragile.

    Chez Tommy Montégu Conseil, nous aidons les entrepreneurs, startups et dirigeants à prendre du recul sur les choix qui influencent leur capacité à grandir et à rentabiliser leur activité.

    Selon les problématiques rencontrées, cette réflexion peut notamment concerner :

    • la capacité du système à accompagner la croissance ;
    • les coûts technologiques ;
    • l’organisation des équipes ;
    • l’automatisation ;
    • la scalabilité ;
    • le choix entre construction interne et solutions existantes ;
    • les arbitrages entre simplicité, coûts et performance.

    Parce qu’une bonne infrastructure n’est pas nécessairement celle qui utilise le plus de technologies.

    C’est celle qui permet à l’entreprise de croître sans créer une complexité disproportionnée par rapport au problème qu’elle doit résoudre.

  • Quelle formation pour devenir un hacker ?

    Lors de mes passages à l’IUT de Saint-Pierre en tant qu’enseignant vacataire en cybersécurité, beaucoup d’étudiants m’ont demandé la suite logique pour eux, après le BUT, pour devenir un hacker (éthique or not !).

    J’enseigne également pour la licence mécatronique & robotique, et pour les ingénieurs de l’ESIROI. Et j’ai côtoyé au cours de ma vie professionnel un bon nombre d’étudiants, d’apprentis qui étaient en recherche de leur parcours « scolaire ».

    Ce à quoi je leur réponds tous : l’école n’est qu’un moyen pour atteindre votre objectif. Vous ne devez pas miser sur l’école que vous allez choisir, mais bien sur vous.

    Woaw ! Quel grand philosophe ce Tommy.

    Je sais, c’est la réponse bateau qu’on retrouve partout sur internet. Il ne suffit de voir le nombre de personnes qui prennent Bill Gates ou Steve Jobs en exemple.

    Pour ma part, je vais parler de ce que moi j’ai connu :

    • J’ai fait une école superbe avec de bons professeurs : IUT de Saint-Pierre
    • J’en ai fait une moins bonne avec des professeurs qui se formaient sur OpenClassRoom : HESIP

    Cependant, ce n’est pas pour ça qu’aujourd’hui je me considère bon..ou mauvais.

    L’école n’est qu’un moyen pour atteindre notre but ultime. La vraie question n’est pas de savoir quelle école je souhaite faire, mais qu’est ce que je veux être après.

    Ensuite, peu importe qu’on fasse Polytechnique ou Expernet, si on s’en donne les moyens, on y arrivera.

    Les recruteurs de nos jours (j’en fais partie, et j’en connais quelques uns), ne se basent plus que sur des CVs ou des diplômes. On est à la recherche de personnes qui partagent les mêmes valeurs que nous, qui ont une capacité d’adaptation, qui savent s’approprier un but, un objectif et se donner les moyens de les atteindre.

    C’est ce que l’on voit chez les entrepreneurs à succès. Certes, quelqu’un de HEC aura de meilleures bases que nous en finance, commerce, marketing. Mais si on sait de qui s’entourer, là où chercher et se former, on peut atteindre des objectifs que même ces personnes là (comme elle ne se sont pas fixées ces objectifs), n’atteindront.

    Alors à la question : quelle formation pour hacker le Facebook de mon ex ? Je vous répondrai : fais celle qui t’arrange le mieux. Il y a de nombreuses écoles et choisis les en fonction de tes contraintes et envies.

    Si pour toi cela passe absolument par une école reconnue, et ben feu.

    Mais si tu veux rester sur l’île de la Réunion proche de ta famille, et bien tes choix sont plus limitées.

    Mais ce n’est pas pour autant que tu seras moins bon ou que tu n’atteindras pas ton objectif.

    Grâce à Internet et à l’intelligence artificielle, tout le monde a accès au même niveau de connaissances. A toi de les transformer en compétences et de voir ce que tu souhaites en faire.

    Mais si une notion est importante : ce sont les bases. L’essentiel, en informatique, c’est de comprendre les bases mêmes.

    L’exemple que je donne à mes apprentis et étudiants : si tu veux être bon en informatique, il faut que si demain on t’envoi à la préhistoire, tu sois capable de recréer internet ou au moins savoir par quoi recommencer.