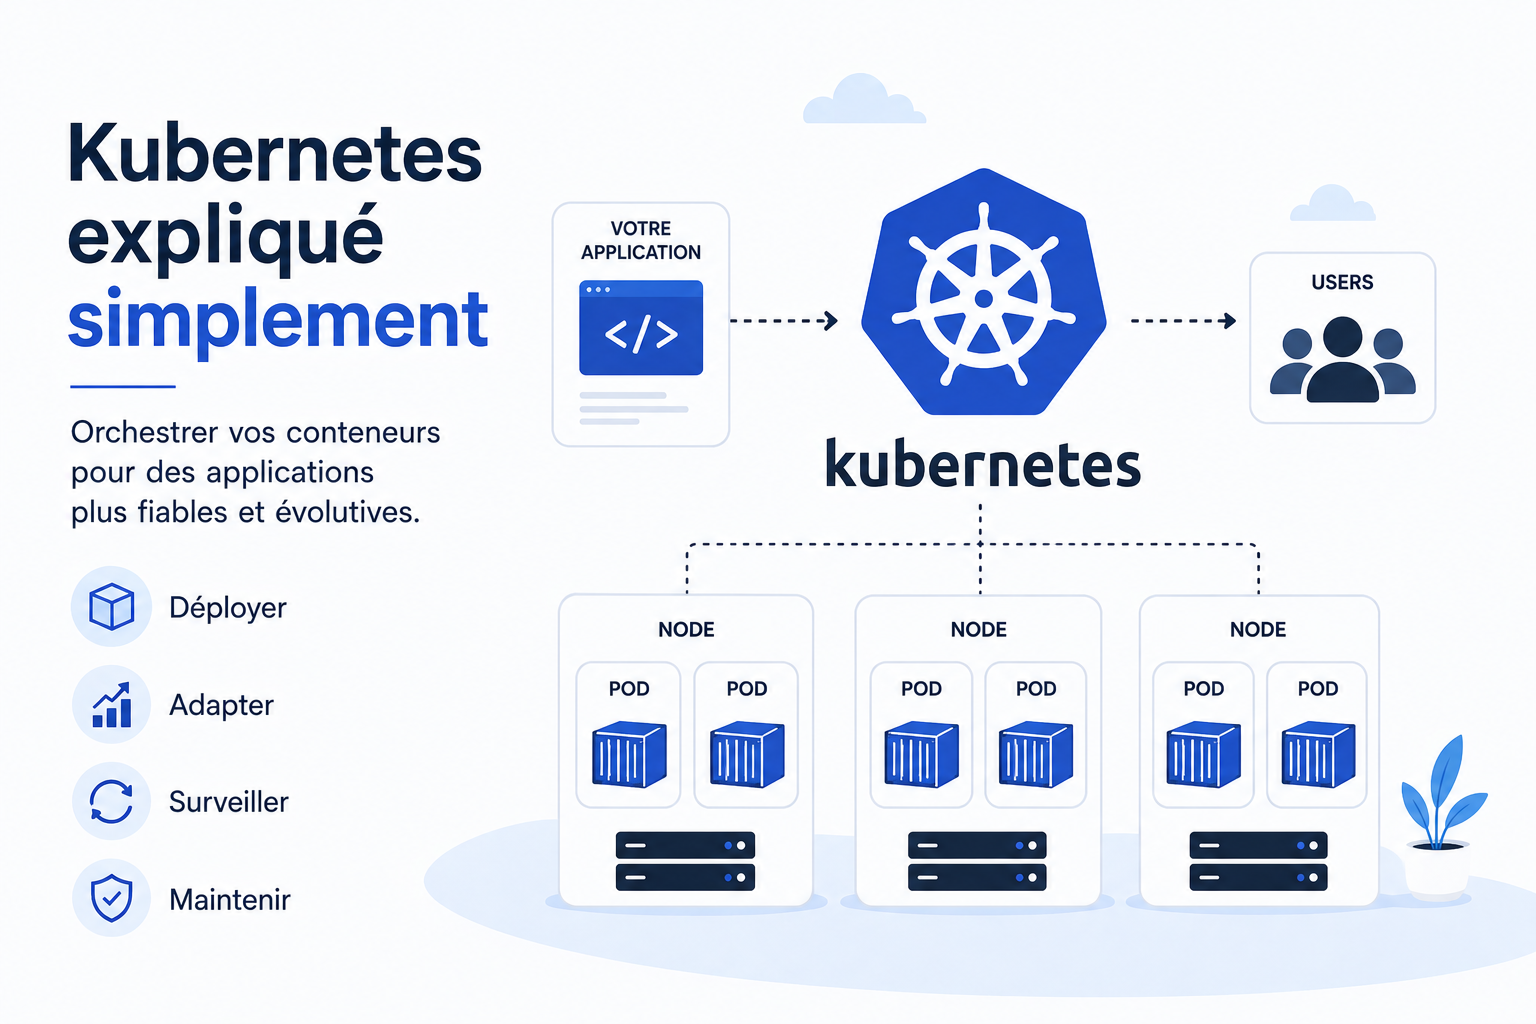
Kubernetes.
Le mot apparaît dans presque toutes les conversations autour du cloud, du DevOps et des infrastructures modernes.
Les développeurs en parlent.
Les ingénieurs DevOps en parlent.
Les fournisseurs cloud en parlent.
Les offres d’emploi le mentionnent.
Et lorsque l’on cherche une explication en ligne, on tombe souvent sur des expressions comme :
“orchestration de workloads conteneurisés”
“architecture distribuée”
“control plane”
“autoscaling horizontal”
“gestion déclarative de l’état”
Techniquement, tout cela est correct.
Mais si vous découvrez Kubernetes, cela ne vous aide probablement pas beaucoup.
Alors commençons autrement.
Imaginez que vous possédez un restaurant.
Vous n’avez qu’un seul cuisinier.
Tout fonctionne correctement lorsqu’il y a 20 clients.
Puis 200 personnes arrivent.
Vous devez rapidement :
- ajouter des cuisiniers ;
- répartir les commandes ;
- vérifier que personne ne manque d’ingrédients ;
- remplacer immédiatement un cuisinier absent ;
- rediriger les commandes si un poste de travail tombe en panne ;
- réduire l’équipe lorsque le restaurant se vide.
Maintenant imaginez un système capable de gérer automatiquement une grande partie de cette organisation.
Pour les applications informatiques, Kubernetes joue en partie ce rôle.
La définition officielle est la suivante : Kubernetes est une plateforme open source destinée à gérer des applications conteneurisées en automatisant notamment leur déploiement, leur montée en charge et leur exploitation. Le projet a été ouvert par Google en 2014 et est aujourd’hui hébergé par la Cloud Native Computing Foundation.
En version simple :
Kubernetes est un système qui aide à faire fonctionner automatiquement de nombreux conteneurs informatiques, même lorsque les applications grossissent, tombent en panne ou doivent être mises à jour.
Et pour comprendre pourquoi cela peut être extrêmement utile, il faut d’abord revenir aux conteneurs.
Avant Kubernetes : comprendre les conteneurs
Imaginez que votre entreprise développe une application.
Pour fonctionner, cette application a besoin de plusieurs choses :
- son code ;
- une certaine version de Python ou Node.js ;
- différentes bibliothèques ;
- certaines configurations ;
- différents composants système.
Le problème est classique.
Un développeur dit :
“Chez moi, ça fonctionne.”
Puis l’application est installée sur un serveur.
Et là :
“Ça ne fonctionne plus.”
Pourquoi ?
Parce que l’environnement est différent.
Les versions ne sont pas les mêmes.
Des dépendances manquent.
Une configuration change.
Les conteneurs ont notamment été popularisés pour réduire ce genre de problème.
Qu’est-ce qu’un conteneur ?
Un conteneur permet d’emballer une application avec une grande partie de ce dont elle a besoin pour fonctionner.
Imaginez une boîte.
À l’intérieur :
- l’application ;
- ses bibliothèques ;
- ses dépendances ;
- sa configuration d’exécution.
Cette boîte peut ensuite être exécutée dans différents environnements de manière beaucoup plus cohérente.
C’est notamment ce que permettent les technologies de conteneurisation comme Docker.
Une analogie intéressante est celle du transport maritime.
Avant la standardisation des conteneurs de fret, transporter des marchandises très différentes était compliqué.
Puis nous avons créé une boîte standard.
Peu importe ce qu’elle contient :
- vêtements ;
- matériel ;
- nourriture.
Le port sait comment déplacer la boîte.
Le bateau sait comment transporter la boîte.
Le camion sait comment transporter la boîte.
Dans l’informatique moderne, le conteneur joue un rôle comparable.
Mais alors, si Docker existe, pourquoi avons-nous besoin de Kubernetes ?
Parce qu’utiliser quelques conteneurs est relativement simple.
En gérer des centaines ou des milliers l’est beaucoup moins.
Imaginez une application composée de :
- 20 conteneurs pour le frontend ;
- 30 conteneurs pour l’API ;
- 10 services internes ;
- plusieurs workers ;
- différents environnements.
Maintenant ajoutez :
- plusieurs serveurs ;
- plusieurs régions ;
- des pics de trafic ;
- des déploiements quotidiens ;
- des pannes.
Très vite, de nouvelles questions apparaissent.
Quel conteneur doit fonctionner sur quel serveur ?
Que faire lorsqu’un conteneur tombe en panne ?
Comment en démarrer davantage lorsque le trafic augmente ?
Comment envoyer les utilisateurs vers les bons conteneurs ?
Comment remplacer progressivement une ancienne version de l’application par une nouvelle ?
Comment utiliser efficacement les ressources disponibles ?
C’est précisément ici que Kubernetes devient intéressant.
La documentation officielle explique notamment que Kubernetes sait gérer le scaling, le failover, les déploiements progressifs, le load balancing, la découverte de services et le redémarrage de conteneurs défaillants.
Kubernetes est donc un orchestrateur
Le mot utilisé est :
orchestration de conteneurs.
Imaginez un chef d’orchestre.
Il ne joue pas directement :
- du violon ;
- du piano ;
- de la trompette ;
- de la batterie.
Il coordonne l’ensemble.
Kubernetes fait quelque chose de comparable avec les conteneurs.
Vous lui dites essentiellement :
“Je veux que mon application fonctionne comme ceci.”
Puis Kubernetes travaille en permanence pour maintenir cette situation.
Le concept le plus important de Kubernetes : l’état désiré
C’est probablement LE concept à comprendre.
Kubernetes fonctionne beaucoup autour d’une logique déclarative.
Vous ne lui dites pas nécessairement :
“Démarre ce conteneur sur le serveur numéro 3.”
Vous dites plutôt :
“Je veux que trois exemplaires de cette application fonctionnent en permanence.”
Kubernetes regarde alors la réalité.
Il trouve :
3 exemplaires.
Tout va bien.
Puis l’un tombe en panne.
Situation actuelle :
Situation désirée :
Kubernetes essaie donc d’en recréer un.
La documentation officielle décrit cette logique comme le rapprochement permanent entre l’état actuel du cluster et l’état souhaité déclaré par l’utilisateur.
C’est une différence fondamentale.
Exemple extrêmement simple
Vous possédez une application appelée :
TommyApp
Vous dites à Kubernetes :
“Je veux toujours cinq instances de TommyApp.”
Kubernetes en lance cinq.
Une tombe en panne.
Il en reste quatre.
Kubernetes constate :
désiré : 5
réel : 4
Il crée donc une nouvelle instance.
Quelques secondes plus tard :
désiré : 5
réel : 5
Voilà une grande partie de la philosophie Kubernetes.
Qu’est-ce qu’un cluster Kubernetes ?
Kubernetes fonctionne à l’intérieur de ce que l’on appelle un :
cluster.
Un cluster est simplement un ensemble de machines travaillant ensemble.
Ces machines peuvent être :
- physiques ;
- virtuelles ;
- hébergées dans le cloud.
La documentation officielle distingue deux grandes parties dans un cluster :
le control plane
et :
les worker nodes.
Voyons cela simplement.
Le Control Plane : le cerveau
Le Control Plane prend les grandes décisions concernant le cluster.
Il sait notamment :
- ce que vous voulez exécuter ;
- ce qui fonctionne actuellement ;
- quelles machines sont disponibles ;
- où envoyer les workloads.
Imaginez :
la tour de contrôle d’un aéroport.
Elle ne transporte aucun passager.
Mais elle coordonne le fonctionnement global.
Les Nodes : les machines qui travaillent
Les nodes sont les machines sur lesquelles les applications sont réellement exécutées.
On les appelle souvent :
worker nodes.
Imaginez un entrepôt.
Le Control Plane est le responsable logistique.
Les nodes sont les zones dans lesquelles le travail est réalisé.
Un cluster peut avoir :
- 1 node ;
- 3 nodes ;
- 50 nodes ;
- des centaines de nodes.
Cela dépend de l’infrastructure.
Et Kubernetes décide où placer les applications
Imaginons trois machines.
Node A
CPU disponible : faible.
Node B
CPU disponible : élevé.
Node C
CPU disponible : moyen.
Une nouvelle application doit être lancée.
Kubernetes peut examiner les contraintes et ressources disponibles afin de déterminer où placer le nouveau workload.
Le composant chargé notamment de cette décision s’appelle :
kube-scheduler.
Vous n’avez donc pas nécessairement besoin de gérer manuellement chaque placement.
Maintenant, parlons du mot que vous verrez absolument partout : Pod
Si vous lisez seulement une notion Kubernetes aujourd’hui, retenez celle-ci.
Le plus petit objet informatique déployable dans Kubernetes est appelé :
Pod.
La documentation officielle définit le Pod comme la plus petite unité de calcul déployable que Kubernetes peut créer et gérer.
Dans la majorité des cas, un Pod contient un conteneur principal.
Il peut néanmoins en contenir plusieurs lorsqu’ils doivent fonctionner très étroitement ensemble.
Pourquoi Kubernetes ne gère-t-il pas directement simplement “des conteneurs” ?
Parce qu’il introduit une couche supplémentaire.
Imaginez :
conteneur → application emballée
Pod → environnement d’exécution Kubernetes contenant un ou plusieurs conteneurs
Cela permet notamment aux conteneurs présents dans un même Pod de partager certaines ressources réseau et de stockage.
Mais pour débuter, retenez simplement :
Pod ≈ l’unité dans laquelle Kubernetes fait fonctionner votre application.
Exemple
Votre application web fonctionne dans un conteneur.
Kubernetes démarre ce conteneur dans :
Pod 1
Puis vous voulez trois exemplaires.
Vous obtenez :
Pod 1
Pod 2
Pod 3
Les trois exécutent la même application.
Mais on ne crée généralement pas directement les Pods
Voilà une autre notion importante.
Les Pods sont relativement éphémères.
Ils peuvent :
- disparaître ;
- être recréés ;
- changer d’adresse IP.
La documentation Kubernetes souligne explicitement qu’un Pod individuel ne doit pas être considéré comme une ressource durable.
On utilise donc généralement des objets qui les gèrent.
Le plus connu est :
Deployment.
Qu’est-ce qu’un Deployment ?
Un Deployment indique à Kubernetes comment une application doit être déployée et maintenue.
Par exemple :
Application : TommyApp
Version : 2.1
Réplicas : 5
Kubernetes essaiera de maintenir cinq Pods exécutant cette version.
La documentation officielle précise qu’un Deployment fournit des mises à jour déclaratives pour les Pods et les ReplicaSets.
En langage simple :
Le Deployment est le responsable qui veille à ce que la bonne version de votre application fonctionne avec le bon nombre d’exemplaires.
Pourquoi lancer plusieurs exemplaires de la même application ?
Pour plusieurs raisons.
Disponibilité
Si l’un tombe en panne, les autres continuent.
Performance
Les utilisateurs peuvent être répartis entre plusieurs instances.
Scalabilité
Vous pouvez augmenter le nombre d’instances lorsque la demande augmente.
Par exemple :
Trafic normal :
3 Pods.
Black Friday :
20 Pods.
Puis après le pic :
5 Pods.
Kubernetes peut-il faire cela automatiquement ?
Oui.
Kubernetes possède notamment un mécanisme appelé :
Horizontal Pod Autoscaler, ou HPA.
Il peut ajuster automatiquement le nombre de Pods d’un workload selon certaines métriques, par exemple l’utilisation CPU, la mémoire ou des métriques personnalisées.
Imaginez :
CPU moyen > 70 %.
Kubernetes augmente progressivement :
5 Pods → 8 → 12.
Le trafic redescend.
Kubernetes peut ensuite réduire :
12 → 8 → 5.
C’est ce qu’on appelle du horizontal scaling.
Horizontal scaling et vertical scaling
Deux notions à distinguer.
Scaling vertical
Vous rendez une machine plus puissante.
Exemple :
4 Go RAM → 16 Go RAM.
C’est comme remplacer un employé par un super-employé.
Scaling horizontal
Vous ajoutez davantage d’instances.
Exemple :
3 Pods → 15 Pods.
C’est comme ajouter des employés supplémentaires.
Kubernetes est particulièrement adapté au deuxième modèle.
Mais comment les utilisateurs savent-ils vers quel Pod aller ?
Très bonne question.
Les Pods peuvent être créés et détruits régulièrement.
Leur identité réseau peut donc changer.
Vous ne voulez évidemment pas que votre application mobile doive connaître :
Pod 1 : 10.0.2.53
Pod 2 : 10.0.8.17
Pod 3 : 10.0.7.29
Et devoir mettre à jour cette liste en permanence.
Kubernetes possède pour cela un objet appelé :
Service.
Qu’est-ce qu’un Service Kubernetes ?
Un Service fournit un point d’accès stable devant plusieurs Pods.
La documentation officielle définit le Service comme un moyen d’exposer une application réseau composée d’un ou plusieurs Pods derrière un endpoint cohérent.
Imaginez un restaurant.
Vous appelez :
01 23 45 67 89
Vous ne savez pas quel employé répondra.
Et peu importe.
Le numéro reste le même.
Le Service fonctionne un peu de cette manière.
Exemple
Votre Service s’appelle :
api-tommy
Derrière :
Pod A
Pod B
Pod C
Une requête arrive.
Le Service permet de l’envoyer vers l’un des Pods disponibles.
Si Pod B disparaît :
Pod A
Pod C
Le Service continue de fonctionner.
Puis Kubernetes recrée :
Pod D
Le système peut reprendre normalement.
Et pour recevoir du trafic venant d’Internet ?
C’est là que l’on rencontre d’autres mécanismes de networking Kubernetes.
Selon l’architecture, on peut utiliser :
- un Service de type LoadBalancer ;
- Ingress ;
- ou désormais différents mécanismes basés sur la Gateway API.
Pour un débutant, retenez simplement :
Kubernetes possède plusieurs couches permettant de diriger le trafic extérieur vers les bonnes applications à l’intérieur du cluster.
Il n’est pas nécessaire d’en comprendre tous les détails pour saisir le principe général.
Kubernetes est capable de s’auto-réparer
C’est l’un de ses avantages les plus connus.
Imaginez :
10 instances de votre application fonctionnent.
Deux plantent.
Kubernetes détecte la situation et peut les remplacer.
Il peut également redémarrer certains conteneurs défaillants et éviter d’envoyer du trafic vers des instances qui ne sont pas encore considérées comme prêtes.
C’est ce que l’on appelle souvent :
self-healing.
Attention toutefois.
Cela ne signifie pas que Kubernetes peut réparer :
- un bug dans votre code ;
- une mauvaise architecture ;
- une base de données corrompue.
Il peut remplacer un composant qui ne fonctionne plus.
Il ne transforme pas automatiquement un mauvais logiciel en bon logiciel.
Comment Kubernetes sait-il qu’une application fonctionne ?
Il existe notamment des mécanismes appelés :
probes.
Par exemple :
Readiness Probe
Question :
“Cette application est-elle prête à recevoir du trafic ?”
Liveness Probe
Question :
“Cette application fonctionne-t-elle toujours correctement ?”
Startup Probe
Question :
“L’application a-t-elle terminé son démarrage ?”
Ces vérifications permettent à Kubernetes de prendre de meilleures décisions.
Exemple concret
Votre API démarre normalement en 20 secondes.
Pendant ces 20 secondes, elle ne doit pas recevoir de trafic.
Une readiness probe peut permettre à Kubernetes de savoir :
“Pas encore prête.”
Puis :
“Prête.”
Le trafic peut alors commencer.
Kubernetes facilite également les mises à jour
Imaginez que votre application fonctionne avec :
10 Pods version 1.
Vous souhaitez déployer :
version 2.
Sans orchestration correcte, vous pourriez :
- arrêter les 10 anciennes instances ;
- déployer les nouvelles ;
- espérer que tout fonctionne.
Résultat possible :
plusieurs minutes d’indisponibilité.
Kubernetes peut effectuer un rolling update.
Par exemple :
10 version 1
puis :
8 version 1 + 2 version 2
puis :
6 + 4
puis :
4 + 6
puis :
2 + 8
puis :
10 version 2.
Les Deployments sont justement conçus pour permettre ce type de mise à jour progressive.
Et si la nouvelle version fonctionne mal ?
Selon la manière dont votre déploiement et votre pipeline sont configurés, vous pouvez revenir vers une version antérieure.
C’est ce qu’on appelle :
rollback.
Kubernetes fournit les briques permettant de réaliser ces changements de manière contrôlée.
ConfigMap : séparer le code de la configuration
Imaginez votre application.
Elle possède différentes configurations.
En développement
API_URL = localhost
En production
API_URL = api.monsite.com
Vous ne voulez pas nécessairement créer une nouvelle image de conteneur pour chaque petit changement de configuration.
Kubernetes propose notamment les :
ConfigMaps.
Ils permettent de stocker certaines configurations séparément de l’image applicative.
Et les mots de passe ?
On évite évidemment d’écrire directement :
PASSWORD = “supermotdepasse123”
dans le code.
Kubernetes possède un objet :
Secret.
Il permet de gérer certaines informations sensibles comme :
- mots de passe ;
- tokens ;
- clés.
La documentation officielle inclut explicitement la gestion de configuration et de secrets parmi les fonctions fournies par Kubernetes.
Attention toutefois :
utiliser un Secret Kubernetes ne garantit pas à lui seul une sécurité parfaite.
La gestion des secrets nécessite une stratégie globale :
- chiffrement ;
- droits d’accès ;
- rotation ;
- gestion des identités ;
- éventuellement coffre-fort externe.
Et les données persistantes ?
Un Pod peut disparaître.
Mais vous ne voulez évidemment pas perdre :
- fichiers ;
- données ;
- contenus utilisateurs ;
chaque fois qu’il est recréé.
Kubernetes possède donc plusieurs mécanismes permettant de gérer le stockage.
Parmi eux :
PersistentVolume
et :
PersistentVolumeClaim.
La documentation officielle indique que Kubernetes sait orchestrer le montage de différents systèmes de stockage, qu’ils soient locaux ou proposés par des fournisseurs cloud.
Une analogie simple pour retenir les principaux objets Kubernetes
Imaginez une chaîne de restaurants.
Cluster
L’ensemble du réseau.
Node
Un restaurant.
Pod
Un poste de cuisine.
Container
Le cuisinier et son équipement de travail.
Deployment
La règle :
“Je veux toujours quatre postes capables de préparer ce plat.”
Service
Le comptoir où arrivent les commandes.
ConfigMap
Le manuel de fonctionnement.
Secret
Les informations confidentielles.
Autoscaler
Le responsable qui ajoute du personnel lorsqu’il y a beaucoup de clients.
Ce n’est évidemment pas techniquement parfait.
Mais cela permet de retenir les rôles.
Que fait Kubernetes lorsqu’un serveur entier tombe en panne ?
Supposons un cluster avec :
Node A
Node B
Node C.
Des Pods fonctionnent sur chaque machine.
Node B tombe en panne.
Kubernetes peut constater que certaines applications ne disposent plus du nombre d’instances désiré.
Il peut alors essayer de recréer les workloads sur les nodes restants si ceux-ci possèdent suffisamment de ressources.
C’est l’une des raisons pour lesquelles Kubernetes est intéressant pour construire des systèmes plus résilients.
Mais attention : Kubernetes ne rend pas automatiquement votre application “haute disponibilité”
C’est une idée reçue.
Vous pouvez déployer une application mal conçue sur Kubernetes.
Elle restera mal conçue.
Par exemple :
vous possédez une base de données unique.
Elle tombe.
Votre application s’arrête.
Même si vos 40 Pods web fonctionnent parfaitement.
La haute disponibilité concerne l’architecture complète :
- application ;
- base de données ;
- réseau ;
- stockage ;
- DNS ;
- fournisseurs externes ;
- zones géographiques.
Kubernetes est une brique.
Pas une baguette magique.
Kubernetes fonctionne-t-il uniquement dans le cloud ?
Non.
C’est justement l’un de ses avantages.
Kubernetes peut être utilisé :
- sur un cloud public ;
- dans un datacenter privé ;
- sur des machines physiques ;
- dans certains environnements hybrides.
La documentation officielle met en avant sa portabilité entre différents clouds et distributions.
On peut notamment trouver des services Kubernetes managés chez les grands fournisseurs cloud.
Kubernetes managé : souvent plus réaliste pour une entreprise
Installer Kubernetes soi-même est possible.
Mais gérer correctement un cluster de production signifie également gérer :
- control plane ;
- upgrades ;
- sécurité ;
- réseau ;
- stockage ;
- sauvegardes ;
- monitoring.
Beaucoup d’entreprises choisissent donc des services Kubernetes managés.
Le fournisseur prend en charge une partie de l’infrastructure.
Cela ne supprime pas toute la complexité.
Mais cela évite d’avoir à tout administrer soi-même.
Kubernetes et Docker : concurrents ?
Non.
C’est une confusion fréquente.
Docker et Kubernetes ne répondent pas exactement au même problème.
Docker a largement popularisé la création et l’exécution de conteneurs.
Kubernetes orchestre des workloads conteneurisés à grande échelle.
En simplifiant :
Docker aide à emballer et exécuter votre application dans un conteneur.
Kubernetes aide à organiser beaucoup de conteneurs dans une infrastructure distribuée.
Ils sont donc conceptuellement complémentaires, même si Kubernetes utilise aujourd’hui des runtimes conformes au standard CRI et n’est pas dépendant du moteur Docker historique.
Que signifie K8s ?
Vous verrez très souvent :
K8s.
Ce n’est pas une autre technologie.
C’est simplement l’abréviation de Kubernetes.
Pourquoi 8 ?
K ubernetes s
Entre le K et le s, il y a huit lettres.
Donc :
K + 8 + s = K8s.
La documentation officielle confirme cette origine.
Pourquoi Kubernetes est devenu aussi populaire ?
Parce qu’il répond à plusieurs problèmes fondamentaux des architectures modernes.
1. Les applications modernes sont de plus en plus distribuées
Au lieu d’une seule application gigantesque, certaines entreprises utilisent plusieurs services.
Par exemple :
- service utilisateurs ;
- service paiement ;
- service commandes ;
- service e-mail ;
- service facturation.
Kubernetes facilite le déploiement et la coordination de ce type d’environnement.
2. Les entreprises déploient plus fréquemment
Les équipes modernes peuvent déployer :
- toutes les semaines ;
- tous les jours ;
- parfois plusieurs fois par jour.
Kubernetes fournit des mécanismes permettant d’automatiser une partie des rollouts et rollbacks.
3. Les besoins en capacité changent rapidement
Un site peut recevoir :
10 000 visiteurs lundi.
Puis :
500 000 mardi après une campagne.
Une infrastructure statique peut être :
trop petite pendant les pics,
et :
trop chère pendant les périodes calmes.
L’autoscaling peut permettre une meilleure adaptation.
4. La disponibilité est devenue critique
Pour certains services :
une panne de dix minutes peut coûter très cher.
Kubernetes peut aider à créer une infrastructure capable de remplacer automatiquement certains composants défaillants.
5. Les entreprises veulent davantage de portabilité
Une application fortement dépendante d’une seule infrastructure peut être difficile à déplacer.
La standardisation autour des conteneurs et de Kubernetes peut réduire certaines dépendances.
Mais attention :
Kubernetes ne supprime pas automatiquement le vendor lock-in.
Si votre architecture dépend fortement :
- d’une base propriétaire ;
- d’un service cloud spécifique ;
- d’une solution réseau particulière ;
la migration restera potentiellement difficile.
Kubernetes et les microservices
Kubernetes est souvent associé aux :
microservices.
Dans une architecture monolithique, une grande partie de l’application est regroupée.
Dans une architecture microservices, différentes fonctionnalités peuvent devenir des services indépendants.
Exemple :
Monolithe
Application e-commerce unique.
Microservices
catalogue
paiement
utilisateurs
commandes
notifications
livraison
Chacun peut parfois être :
- développé indépendamment ;
- déployé indépendamment ;
- scalé indépendamment.
Kubernetes est particulièrement adapté à la gestion de ce type d’environnement.
Mais cela ne signifie pas que toutes les entreprises doivent adopter les microservices.
Le piège : croire que microservices + Kubernetes = architecture moderne
Vous avez trois développeurs.
Votre application compte 200 utilisateurs.
Votre architecture fonctionne parfaitement.
Puis quelqu’un dit :
“Il faut passer en microservices Kubernetes.”
Pourquoi ?
“Parce que c’est plus scalable.”
Vous pourriez alors transformer une application relativement simple en :
- 25 services ;
- 25 pipelines ;
- plusieurs bases ;
- networking complexe ;
- monitoring distribué ;
- Kubernetes.
Vous venez peut-être de créer énormément de travail sans résoudre aucun problème réel.
Une technologie moderne n’est pas nécessairement une technologie adaptée à votre entreprise.
Quand Kubernetes devient réellement intéressant
Kubernetes commence généralement à avoir davantage de sens lorsque plusieurs de ces conditions sont réunies.
Votre application possède plusieurs services
L’orchestration commence à créer de la valeur.
Vous avez besoin d’une forte disponibilité
La capacité de remplacement automatique devient intéressante.
Votre trafic varie fortement
L’autoscaling peut être utile.
Vous effectuez beaucoup de déploiements
Les rollouts automatisés prennent davantage de valeur.
Plusieurs équipes travaillent sur la plateforme
La standardisation peut simplifier l’exploitation.
Vous avez besoin de cohérence entre plusieurs environnements
Par exemple :
cloud + datacenter.
Votre infrastructure est devenue difficile à gérer manuellement
C’est probablement le signal le plus important.
Quand Kubernetes est probablement excessif
Imaginez :
- une petite entreprise ;
- une application simple ;
- trois développeurs ;
- peu de trafic ;
- une architecture monolithique ;
- un serveur stable.
Kubernetes peut ajouter :
- complexité ;
- coûts ;
- maintenance ;
- compétences nécessaires ;
- temps de debug.
Sans créer suffisamment de valeur.
Dans ce cas, des solutions plus simples peuvent être largement suffisantes :
- PaaS ;
- services serverless ;
- containers managés ;
- machines virtuelles ;
- Docker Compose pour certains environnements limités.
Une règle simple
Ne demandez pas :
“Est-ce que Kubernetes est une bonne technologie ?”
Oui.
C’est une technologie extrêmement puissante.
Demandez plutôt :
“Les problèmes que Kubernetes résout existent-ils réellement chez nous ?”
C’est une question beaucoup plus intelligente.
Les avantages de Kubernetes
Résumons.
Automatisation
Déploiement, remplacement de workloads, scaling.
Résilience
Des composants défaillants peuvent être recréés.
Scalabilité
Le nombre d’instances peut évoluer.
Portabilité
Kubernetes fonctionne dans de nombreux environnements.
Standardisation
Les équipes disposent d’un modèle cohérent.
Optimisation des ressources
Kubernetes peut répartir les workloads selon les ressources disponibles.
Écosystème
L’écosystème Kubernetes est aujourd’hui extrêmement important.
Les inconvénients de Kubernetes
Et ils existent.
Complexité
Kubernetes possède énormément de concepts.
Pods.
Deployments.
Services.
Ingress.
Volumes.
Namespaces.
RBAC.
Operators.
CRD.
Helm.
Etc.
Coût humain
La technologie nécessite des compétences.
Une mauvaise configuration Kubernetes peut être :
- coûteuse ;
- fragile ;
- difficile à maintenir.
Coût opérationnel
Un cluster possède ses propres ressources et outils périphériques.
Monitoring.
Logging.
Sécurité.
Backups.
Réseau.
Debug plus difficile
Dans un serveur traditionnel :
“L’application ne marche plus.”
Dans Kubernetes :
Pod ?
Service ?
DNS ?
Ingress ?
Network Policy ?
stockage ?
node ?
image ?
configuration ?
L’architecture distribuée crée de nouveaux problèmes.
Kubernetes ne remplace pas le DevOps
Autre idée reçue.
Installer Kubernetes ne crée pas automatiquement une culture DevOps.
Vous avez toujours besoin de :
- CI/CD ;
- monitoring ;
- logs ;
- sécurité ;
- gestion des incidents ;
- tests ;
- automatisation ;
- pratiques d’exploitation.
Kubernetes devient simplement une partie de la plateforme.
Que faut-il ajouter autour de Kubernetes ?
Un environnement de production réaliste peut inclure :
CI/CD
Pour construire et déployer les applications.
Registry
Pour stocker les images de conteneurs.
Observabilité
Metrics, logs et traces.
Gestion des secrets
Pour les informations sensibles.
Sauvegarde
Pour les workloads et données concernés.
Sécurité
RBAC, policies, scanning, etc.
DNS
Pour résoudre les services.
Kubernetes fournit une base importante.
Mais pas nécessairement tout le système.
La documentation officielle précise d’ailleurs clairement que Kubernetes n’est pas une plateforme PaaS monolithique intégrant obligatoirement toutes les briques possibles.
Kubernetes expliqué avec un exemple complet
Imaginons un e-commerce.
Vous avez trois composants :
Frontend
Le site visible par les clients.
API
La logique métier.
Worker
Traitement des commandes en arrière-plan.
Vous conteneurisez chaque application.
Étape 1
Vous créez un cluster.
3 nodes.
Étape 2
Vous dites :
frontend : 4 Pods
API : 5 Pods
worker : 2 Pods
Étape 3
Kubernetes répartit les Pods sur les machines.
Étape 4
Vous créez des Services.
Le frontend peut trouver l’API.
Étape 5
Vous exposez le frontend à Internet.
Étape 6
Black Friday arrive.
Le CPU de l’API augmente.
Un autoscaler peut augmenter :
5 → 15 Pods.
Étape 7
Un node tombe en panne.
Certains Pods disparaissent.
Kubernetes essaie de les recréer ailleurs.
Étape 8
Vous déployez API v2.
Kubernetes remplace progressivement :
v1 → v2.
C’est ce type de scénario qui permet de comprendre pourquoi Kubernetes peut être extrêmement puissant.
Quelques mots Kubernetes à connaître absolument
Cluster
Ensemble de machines Kubernetes.
Node
Machine du cluster.
Pod
Plus petite unité déployable.
Container
Application emballée avec ses dépendances.
Deployment
Objet qui gère notamment plusieurs Pods d’une application.
Service
Point réseau stable permettant d’accéder à plusieurs Pods.
Namespace
Moyen d’organiser logiquement certaines ressources d’un cluster.
ConfigMap
Configuration non sensible.
Secret
Informations sensibles.
Volume
Stockage mis à disposition des workloads.
kubectl
Outil en ligne de commande utilisé pour communiquer avec Kubernetes.
Qu’est-ce que kubectl ?
kubectl est l’outil en ligne de commande principal utilisé pour interagir avec Kubernetes. La documentation officielle le présente comme la CLI principale permettant de communiquer avec un cluster.
Avec lui, un ingénieur peut notamment :
- voir les Pods ;
- déployer ;
- consulter des logs ;
- modifier des ressources ;
- diagnostiquer des problèmes.
Par exemple :
kubectl get pods
permet de lister les Pods visibles dans un contexte donné.
Pourquoi parle-t-on autant de fichiers YAML ?
Parce que Kubernetes fonctionne beaucoup avec de la configuration déclarative.
Vous pouvez décrire une ressource dans un fichier.
Par exemple, conceptuellement :
Je veux une application
nom : tommy-api
image : tommy-api:v2
replicas : 3
Kubernetes lit cette déclaration.
Puis essaie de faire correspondre la réalité à cette configuration.
Les configurations Kubernetes sont très souvent écrites en :
YAML.
Le véritable changement mental apporté par Kubernetes
Avant :
“Quelle machine fait fonctionner mon application ?”
Avec Kubernetes :
“Quel état applicatif veux-je obtenir ?”
Cette abstraction permet aux équipes de moins se concentrer sur une machine spécifique et davantage sur les propriétés attendues du système.
C’est une différence importante.
Kubernetes est-il réservé aux grandes entreprises ?
Non.
Une petite équipe peut techniquement utiliser Kubernetes.
Mais la vraie question est économique.
Est-ce que les bénéfices justifient :
- la complexité ;
- le coût ;
- l’apprentissage ?
Pour une startup très technique avec une architecture distribuée :
peut-être.
Pour un site vitrine :
probablement pas.
Kubernetes coûte-t-il cher ?
Kubernetes lui-même est open source.
Mais :
open source ne signifie pas gratuit à exploiter.
Vous payez potentiellement :
- les machines ;
- les services cloud ;
- le stockage ;
- le réseau ;
- l’observabilité ;
- les ingénieurs ;
- la maintenance.
La mauvaise utilisation de Kubernetes peut même augmenter fortement vos coûts cloud.
Par exemple, si les ressources CPU et mémoire sont mal dimensionnées.
Kubernetes peut-il réduire les coûts ?
Oui, dans certains contextes.
Parce qu’il peut aider à mieux utiliser les machines disponibles et à répartir les applications selon leurs besoins. La documentation officielle mentionne cette logique d’optimisation de placement, appelée notamment automatic bin packing.
Mais encore une fois :
cela dépend de l’architecture.
Un cluster mal optimisé peut également coûter beaucoup plus cher qu’une solution simple.
Kubernetes et la sécurité
Kubernetes possède de nombreux mécanismes de sécurité.
Par exemple :
- contrôle d’accès ;
- identités ;
- secrets ;
- politiques réseau ;
- sécurité des workloads.
Mais la complexité signifie également qu’une mauvaise configuration peut créer des vulnérabilités.
Une infrastructure Kubernetes doit donc être :
- mise à jour ;
- configurée correctement ;
- monitorée ;
- auditée ;
- sécurisée.
Kubernetes n’est pas sécurisé simplement parce qu’il est Kubernetes.
Faut-il apprendre Kubernetes en 2026 ?
Pour un développeur backend, DevOps, SRE, platform engineer ou cloud engineer :
comprendre Kubernetes reste extrêmement pertinent.
La documentation officielle continue d’être activement maintenue et couvre actuellement les versions Kubernetes récentes, les concepts fondamentaux et de nombreuses fonctions avancées.
Pour un dirigeant ou entrepreneur :
vous n’avez probablement pas besoin de savoir écrire un Deployment YAML.
Mais comprendre :
- pourquoi l’équipe utilise Kubernetes ;
- quel problème cela résout ;
- quel coût cela ajoute ;
- quel risque cela réduit ;
peut être extrêmement utile.
Les 7 questions à poser avant d’adopter Kubernetes
1. Quel problème précis voulons-nous résoudre ?
Pas :
“Parce que tout le monde utilise Kubernetes.”
2. Notre architecture est-elle suffisamment complexe pour le justifier ?
Trois conteneurs ne nécessitent probablement pas le même niveau d’orchestration que 300.
3. Possédons-nous les compétences nécessaires ?
Sinon :
qui maintiendra la plateforme ?
4. Avons-nous réellement besoin de portabilité ?
Si vous comptez rester longtemps sur un fournisseur unique, certains services managés plus simples peuvent être suffisants.
5. Avons-nous besoin de scaling avancé ?
Si votre trafic est stable, l’argument est moins important.
6. Combien cela coûtera-t-il réellement ?
Incluez :
- infrastructure ;
- ingénierie ;
- monitoring ;
- maintenance.
7. Existe-t-il une solution plus simple ?
C’est probablement la question la plus importante.
Checklist : Kubernetes est-il adapté à votre entreprise ?
Plus vous cochez de cases, plus la discussion devient intéressante.
- Plusieurs services doivent être orchestrés.
- L’application doit être fortement disponible.
- Les workloads doivent pouvoir être redémarrés automatiquement.
- Le trafic varie fortement.
- Nous déployons fréquemment.
- Plusieurs équipes utilisent la même infrastructure.
- Notre infrastructure actuelle devient difficile à gérer.
- Nous possédons des compétences DevOps / cloud.
- Nous avons besoin d’une plateforme standardisée.
- Nous avons évalué le coût total de possession.
À l’inverse, si votre projet est :
- simple ;
- stable ;
- peu sollicité ;
- géré par une petite équipe ;
Kubernetes peut être inutilement complexe.
En résumé : Kubernetes en une minute
Si vous ne deviez retenir que cela :
Un conteneur contient votre application.
Un Pod permet à Kubernetes de faire fonctionner un ou plusieurs conteneurs étroitement liés.
Un Node est une machine qui exécute des Pods.
Un Cluster regroupe plusieurs machines.
Un Deployment indique combien de Pods doivent fonctionner et avec quelle version.
Un Service permet d’accéder de manière stable à des Pods qui peuvent apparaître ou disparaître.
Kubernetes observe en permanence l’état réel et essaie de le rapprocher de l’état que vous avez demandé.
Et il peut notamment aider à :
- déployer ;
- scaler ;
- répartir le trafic ;
- remplacer certaines instances défaillantes ;
- gérer les mises à jour ;
- exploiter les ressources disponibles.
Voilà Kubernetes.
Pas une magie obscure.
Pas simplement “Docker mais en plus compliqué”.
Mais :
un système d’orchestration conçu pour permettre à de nombreuses applications conteneurisées de fonctionner de manière plus automatisée et plus résiliente sur une infrastructure distribuée.
Conclusion : Kubernetes est puissant précisément parce qu’il résout des problèmes complexes
Kubernetes peut sembler intimidant.
Et il l’est parfois.
Mais le principe fondamental reste relativement simple.
Vous décrivez :
“Voilà comment je veux que mon application fonctionne.”
Kubernetes observe ensuite :
“Voilà comment elle fonctionne actuellement.”
Puis essaie continuellement de réduire la différence.
Un Pod disparaît ?
Il peut être recréé.
Le trafic augmente ?
La capacité peut être augmentée.
Une nouvelle version arrive ?
Elle peut être déployée progressivement.
Un serveur tombe ?
Certains workloads peuvent être replacés.
C’est cette automatisation qui explique l’importance prise par Kubernetes dans les infrastructures modernes.
Mais le point le plus important pour un dirigeant n’est probablement pas technique.
C’est celui-ci :
Utiliser une technologie sophistiquée n’est pas un objectif. Résoudre un problème métier avec le niveau de complexité approprié l’est.
Une infrastructure Kubernetes parfaitement conçue pour une application qui n’en a pas besoin reste une mauvaise décision.
À l’inverse, lorsqu’une entreprise atteint un niveau de complexité où :
- les déploiements deviennent difficiles ;
- la disponibilité devient critique ;
- les workloads se multiplient ;
- les besoins évoluent constamment ;
Kubernetes peut devenir une plateforme extrêmement puissante.
La bonne question n’est donc pas :
“Devons-nous utiliser Kubernetes parce que c’est moderne ?”
Mais :
“Notre entreprise a-t-elle atteint le niveau de complexité pour lequel Kubernetes crée davantage de valeur qu’il n’ajoute de complexité ?”
C’est cette question qu’il faut résoudre.
Votre infrastructure technique accompagne-t-elle réellement la croissance de votre entreprise ?
La technologie doit permettre à une entreprise de se développer.
Pas devenir une fin en soi.
Une startup peut parfois complexifier son infrastructure beaucoup trop tôt.
Une autre peut au contraire attendre trop longtemps et se retrouver freinée par une architecture devenue fragile.
Chez Tommy Montégu Conseil, nous aidons les entrepreneurs, startups et dirigeants à prendre du recul sur les choix qui influencent leur capacité à grandir et à rentabiliser leur activité.
Selon les problématiques rencontrées, cette réflexion peut notamment concerner :
- la capacité du système à accompagner la croissance ;
- les coûts technologiques ;
- l’organisation des équipes ;
- l’automatisation ;
- la scalabilité ;
- le choix entre construction interne et solutions existantes ;
- les arbitrages entre simplicité, coûts et performance.
Parce qu’une bonne infrastructure n’est pas nécessairement celle qui utilise le plus de technologies.
C’est celle qui permet à l’entreprise de croître sans créer une complexité disproportionnée par rapport au problème qu’elle doit résoudre.